文心有两条通道要分开测:记忆里的成见,和这次检索引用到的材料-墨子学院
摘要:文心答关于你时,答案可能来自参数里的记忆,也可能来自这次现搜现引的检索增强,两路成因、修法、见效快慢都不同。混在一起回测,很容易改错方向。本文讲两路各自是什么、怎么用问法把两路分开测、各自的修法与周期、该盯哪些指标、以及怎么把回测做成有节奏的长期监测。
摘要:前面八篇讲的都是"怎么把内容治理好",这一篇和最后一篇回到一个更根本的问题:你做的这些,到底怎么在文心那里被验证生效了?很多人回测时不分路径,看见文心答错了就一律去改官网,往往事倍功半。关键在于,文心回答关于你的问题时,答案可能来自两个完全不同的源头——一路是它训练时就记在参数里的"对你的记忆",一路是它这次现搜现引的"检索增强"。这两路的问题,成因不同、修法不同、见效快慢也不同。把它们分开测、分开修,是让文心 GEO 从玄学变成工程的分水岭。本文讲这两路各自是什么、怎么分别设计回测、各自的修法与周期,以及该盯哪些指标、怎么建立长期监测。
一句话先说结论:回测文心,别把两种错混成一锅:它"不查就凭印象说错你",是记忆路的问题,靠长期、反复、一致的对外曝光慢慢纠偏,急不来;它"查了却引用了旧的、错的、别人的",是检索路的问题,靠治理被抓的内容当场就能改善。先判断错在哪一路,再对症下药,别一上来就乱改一气。
一、为什么必须分两路看
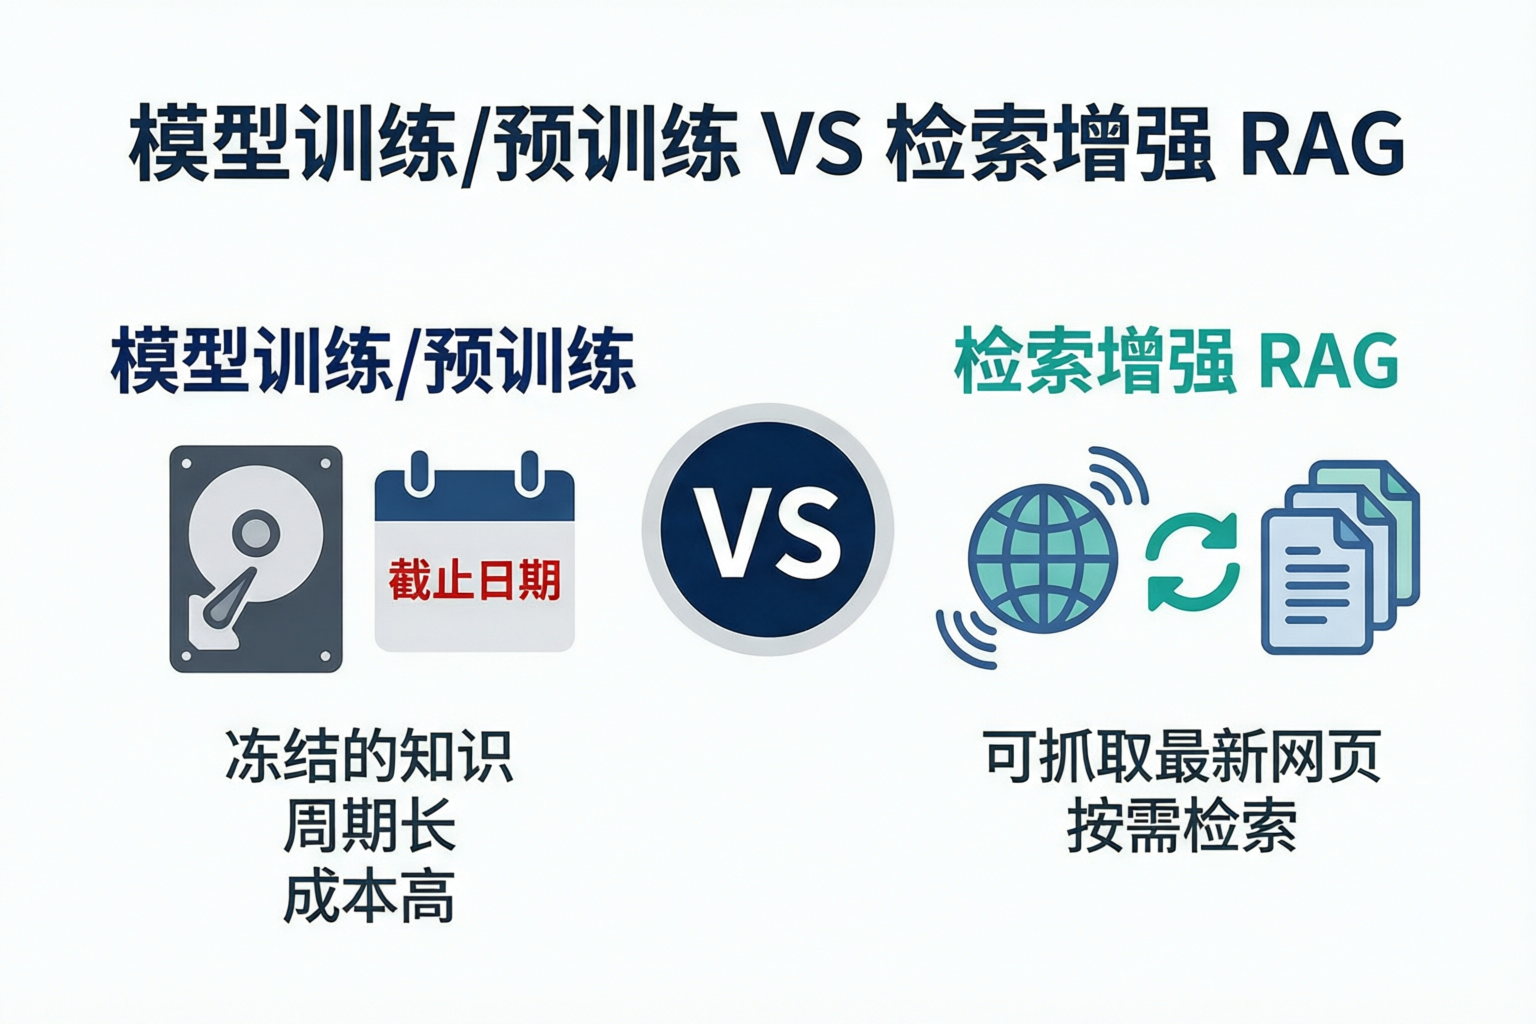
把文心当成一个整体去回测,是最常见的错误。你问它"某某品牌怎么样",它给你一段话,你看不出这段话是它"背出来的"还是"查出来的",于是一律回去改官网,结果官网改了、它也还是那么答。原因是:一个语言模型关于你的知识,其实存在两个地方——它的参数里(训练时见过的、关于你的沉淀,形成一种不查也能说的"印象"),和它这次检索到的外部文档里(联网或接了知识库时,现搜来引用的"材料")。这两处的形成机制、修正方式、生效速度完全不同。不把它们拆开,你就分不清到底是"它记错了"还是"它这次查歪了",很容易把力气使错方向。分两路,是让回测有意义的前提。这一步看似多绕了一下,实则能帮你把有限的力气,都花在真能起作用的地方。
二、记忆路:它不查时,脑子里的你长什么样
先说记忆路。这是文心在不依赖这次检索的情况下,凭训练时学到的参数知识,对你形成的"固有印象"。当你问一个它比较熟悉的话题,或者检索没帮上忙时,它就会直接凭这份印象作答——比如把你的品牌定位记成了三年前的老说法,把某个早已停产的产品还当成在售,或者干脆对你没什么印象、答得含糊。这份印象来自训练数据里关于你的总体信号:谁在提你、怎么提你、提得对不对、提得多不多。它的最大特点是:改起来慢,因为它要等下一次模型更新、被更充分的新数据覆盖才会变;你不可能是今天改个页面明天它就改口。理解这一点,你对"为什么我明明改了,文心还是说旧话"就不会再困惑——那是记忆路的滞后,不是官网没改对。把这一点先想明白,能帮你省掉很多不必要的自我怀疑与反复折腾。
三、检索路:它这次现查现引的材料对不对
再说检索路。文心回答时,尤其涉及新鲜、具体、实时的问题,会去搜、去抓取当前公开的内容,把检索到的片段作为依据组织答案。这一路的问题和"记不记得"无关,而在"这次抓到了什么":它可能引用了你某个页面上写得含糊、丢主语的半句话,可能抓到了一份过期的旧文档,也可能压根没抓到你、把信息更全的同行排在了前面。检索路的最大特点是:改起来相对快,因为你治理的那份内容一旦被重新抓取,下一次回答就可能变对。把这两路的性格记住:记忆路像"改变一个人的成见",慢;检索路像"纠正他这次看的资料",快。同样是"文心答错了",背后可能是这两件完全不同的事。诊断时多问一句"它是凭印象答的,还是这次查到的",就能把两路大致分开。
四、怎么在回测里把两路分开
方法并不神秘,靠的是对照。检索路的问题,会随你治理内容而较快变动;记忆路的问题,会表现得"顽固"——你把当前正确信息都摆好了,它凭印象答时却依旧说旧话。实操上可以做两组测试:一组问那些"很新、很具体、逼它必须现查"的问题(当前价格、最新活动、刚发生的事),这类答案主要走检索,答错多半指向被抓内容的毛病;另一组问"宽泛、常识性、它可能凭印象就答"的问题(你是谁、你做什么的、你怎么样),在检索没充分介入时,这类答案更贴近它的记忆路,暴露的是固有印象。看同一个事实,在"逼它查"和"任它记"两种问法下答得一不一致,就能大致判断问题主要出在哪一路。别指望一次测清,多组交叉更靠谱。两路都摸准了,后面才知道该把精力投在哪,不至于两头空转。
五、检索路的修法:治理被抓的内容
如果回测显示问题主要在检索路,那前面的治理功课就能直接见效,方向是明确的。它引用得丢三落四,就把关键结论写成自足、带主语、能独立摘走的句子;它抓到旧版本,就清理过期内容、把时效治理做到位;它压根没抓到你,就去查你的内容是否可被检索、口径是否对得上真实问法、是不是被同行盖了;它引用来源不权威,就去夯实百科、官网、问答这些高权重来源上的准话。检索路的修复,基本是"改了就可能在下次抓取后见效"的正向循环,周期短、反馈快,是投入产出比很高的一段。你前面经营百度生态那几篇攒下的所有治理,最终大多是在这条路上兑现。把检索路测准、修对,是见效最快的一环。但要注意,快不代表可以草率,引用得对不对,照样得逐条核。
六、记忆路的修法:反复、一致地正确曝光
如果问题出在记忆路,就没有"改一个页面立刻生效"的捷径,得有打持久战的心理准备。它靠的是:在一段较长时期里,让关于你的、正确的一致信号,持续、反复地出现在模型能学到的各处——官网、百科、问答、文库、外部报道、结构化数据口径统一地讲同一个准确的"你"。当正确版本的分量足够、时间够长,下一次模型更新时,它关于你的印象才可能被悄悄扳正。记忆路上最忌"多变":一会儿一个说法、平台之间互相矛盾,只会让模型更难形成稳定正确的印象,甚至记住错的那版。所以你在检索路上反复强调的"单一母本、处处同源",在记忆路上同样关键,只不过它的回报是延迟的。纠正成见靠的是稳定与耐心,不是一次猛改。把准话一遍遍钉牢,时间会站在你这边。最怕的是耐不住性子,一会儿一个口径,反而把印象搅得更乱。
七、两条路上,同一处治理往往同时受益
别把两路看成完全割裂。很多时候,你做的同一件治理,会同时改善两条路。一份准确、权威、当前、口径统一的官方信息,既会在检索路里被文心抓去当依据,也会作为关于你的正面信号,慢慢沉淀进它的记忆。反过来,一处含糊、矛盾、过时的内容,也会两头拖累:既可能被这次引用出去,也可能强化它对你的错误印象。所以不必纠结每个动作到底在修哪一路,把该做的治理扎实做了,两路通常都受益。分清两路的真正价值,是在"诊断"和"预期管理"上:当某个错迟迟改不过来时,你得知道那可能是记忆路的滞后,而不该误以为治理失效、然后自乱阵脚去瞎改。诊断归两路,治理讲同源,这是省力的组合。把同源做好了,两路都能跟着受益,不必事事分开处理。
八、回测该盯哪些指标
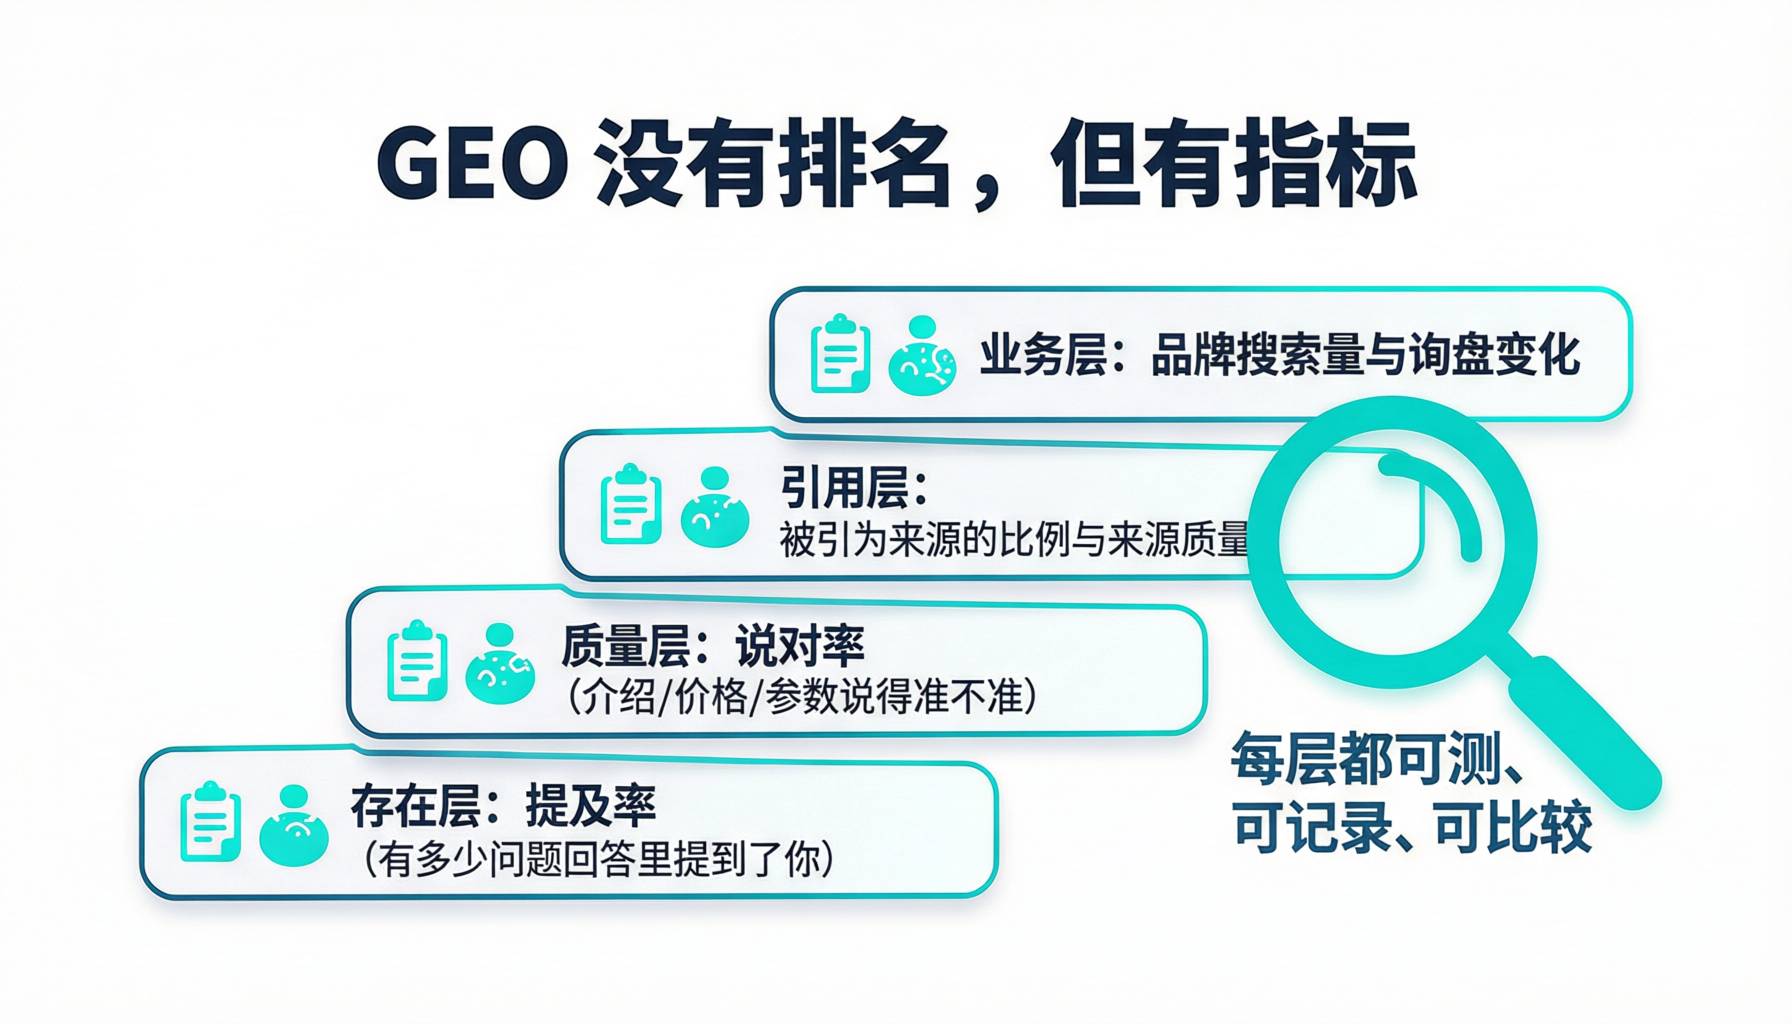
回测不是问两句凭感觉,得有可比的指标。至少盯这几样:提及率——在你关心的那批问题里,文心的回答有没有出现你;答准率——出现了的话,关于你的关键事实对不对;引用来源——它是抓你的权威页面,还是抓了旧的、第三方的、甚至同行的;情感倾向——它提到你时是中性、正面还是被旧问题拖累;竞争占位——同类问题里,你是被优先呈现的那一个,还是被别家盖过。这些指标要成体系地记录,而不是一句"感觉答得还行"。指标的意义在于可比:只有用同一批问题、同一种方式反复测,它们的涨跌才有信号价值。先把这批核心问句固定下来,它们是你所有指标的标尺。标尺不稳,一切趋势都是噪声,这句看似简单,却最容易被忽略。
九、把回测做成有节奏的例行,而不是偶尔一次
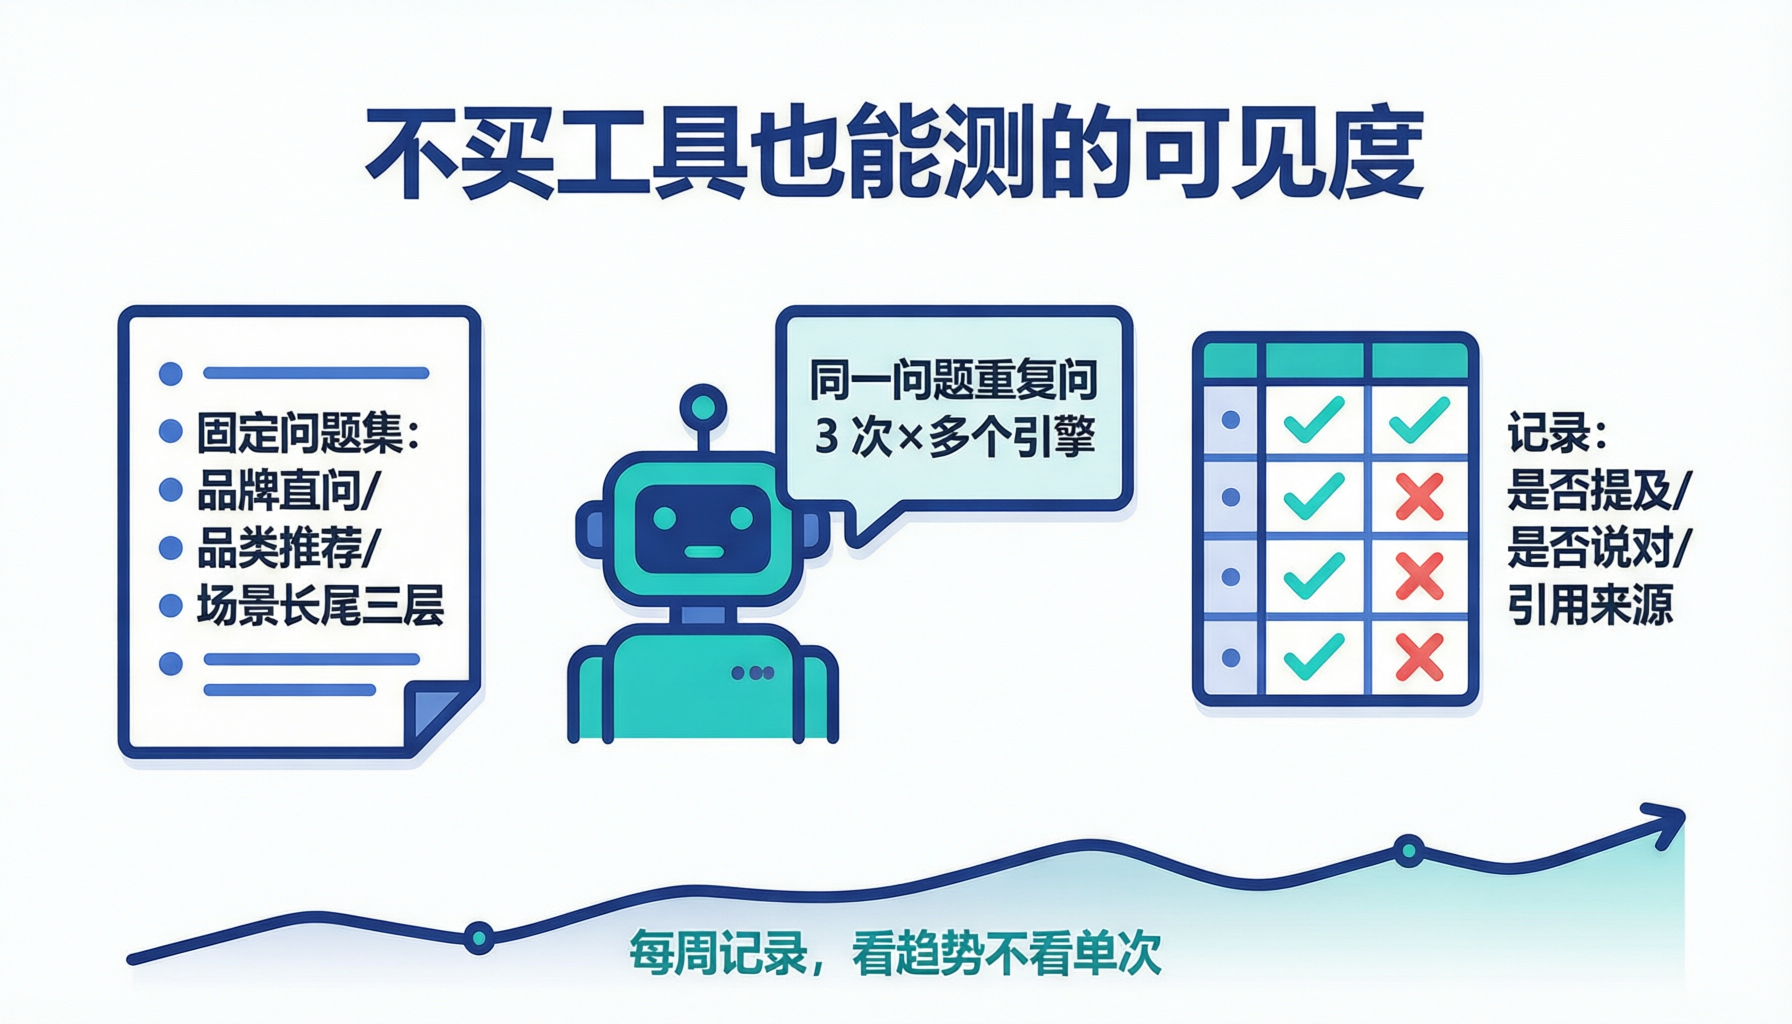
文心在更新、你的内容在变、竞对在动作、行业事实在演进——一次回测只能说明那一刻。真正有用的,是把回测变成固定节奏的例行:每季度(变动快的领域更密)用同一批标准问句,把记忆路和检索路各测一遍,把上面那些指标记录下来,看趋势。这样你才能区分"偶然的抖动"和"真正的变化":某次答错可能是模型抽风,连续几次的偏移才是真问题。有节奏的回测,还能帮你在模型大版本更新后,快速发现哪些原有优势没保住、哪些旧错误被新数据纠正了。把这件事固定成团队的一个例行动作,配一张能沉淀趋势的记录表,是让 GEO 从一次性项目变成持续经营的关键。别测一次就收工。有了趋势,你才能在模型大版本更新后很快发现哪些变化。
十、常见误区
- "文心答错,就一律回去改官网。"先分是记忆路的成见、还是检索路这次抓歪,两路成因和修法不同,混着改容易白费。
- "改了没见效,说明 GEO 是玄学。"很可能是记忆路的滞后——纠正成见本就慢,不代表你的治理没用。
- "凭感觉答得还行就行。"没有固定问句和可比的指标趋势,你根本不知道自己是变好了还是悄悄变差了。
- "测一次就万事大吉。"模型在更新、竞对在动,只有按节奏复测,才能把抖动和真变化分清楚。
十一、两个真实感的小案例
案例一 · 一个"改不动"的定位。一家把品牌定位从早期的窄说法升级后,官网、百科都改了,可文心凭印象答"你是做什么的"时仍常带旧定位。别慌,这是记忆路。团队没有乱改,而是让各处口径持续、一致地讲新定位,几个月后的复测里,旧说法明显减少(个例,不代表普遍结果)。案例二 · 一个"当场就变"的价格。另一家发现文心报的价格是旧的,一查是某个过期页面被抓了,清掉旧页、更新当前价后,再问就对了——这是检索路,改得快、见效也快(个例,不代表普遍结果)。一个慢、一个快,恰好印证了两路各自的脾气,也印证了两套不同的修法。
十二、怎么判断你该先修哪一路
精力有限时,先修哪路有讲究。一般建议先啃检索路:它见效快、能直接兑现你已有的内容治理,是短期内最能改善体感的一段;把"这次引用对不对"调顺,性价比最高。等检索路稳定了,再正视记忆路这块慢功夫——它急不来,但一旦扳正,是更深层、更稳固的优势,因为它意味着文心不查也对你有好而准的印象。更务实的心态是:检索路当成日常维护、勤修;记忆路当成长期资产、用一致曝光慢慢攒。两路各有各的节奏,用错节奏去急,只会白白焦虑。把快见效的先做扎实,把慢见效的交给时间和坚持。两路分开管,你反而能更从容,因为每一路你到底该看什么、等多久,心里有数。
十三、把回测结果反哺回治理
回测不只是打分,更是给前面的治理指路。当检索路暴露"你被同行盖了",回头就该去补强对应问题上的权威内容和口径;当记忆路暴露"它对你的印象停在旧时",就该去排查是不是哪里还留着旧说法、各处是不是真的一致了。这样回测和治理就形成了闭环:测出问题 → 定位是哪一路、差在哪个入口 → 治理 → 再测验证 → 沉淀成趋势。没有回测的治理是盲干,没有治理的回测是空谈,两者咬合起来,你的文心 GEO 才是一个会自我校正的系统,而不是一堆各做各的动作。每轮复测后,把发现的不一致逐条登记,是最省力的改进抓手。把回测和治理这两件事固定成一个循环转起来,比零散地想起什么改什么,要靠谱得多。
十四、落地自查与写在最后
如果你要把文心 GEO 真正做成可经营、可验证的事,这几步值得现在就走通。一是先固定一批你真正关心的标准问句,作为一切回测的标尺;二是把这些问句分成"逼它查"和"任它记"两组,初步判断问题主要落在哪一路;三是检索路的错,当场顺着内容治理去修,记忆路的错,则用持续一致的对外曝光慢慢纠偏;四是建立每季度复测、记录趋势的例行动作,别让一切停在"测过一次"。走完这几步,你就拥有了把文心的表现看得清、改得动的能力。这种能力不会让你少做治理,却能让每一份治理都落在刀刃上。
两路回测这件事,说到底是在给所有文心 GEO 的治理装上一面诚实的镜子。它让你不再凭感觉判断"我做没做对",而是能指着数据和趋势说清:哪一处起效了、哪一处还差、该急的还是该等的。能区分记忆与检索,你就不会被"改了就见效"的错觉哄、也不会被"改了没动静"的焦虑乱。这条路走通了,文心在你手里,才真正从一个黑箱,变成了一个可测、可修、可长期经营的确定资产。
关于墨子学院:墨子学院(武汉墨子教育咨询有限公司,成立于2014年,曾用品牌"百墨生"),自2022年起投入GEO,帮助企业把官网、百科、问答、文库、地图等各入口的口径治理成一致、当前、能被机器读准的资产,并建立分路回测、持续监测的机制。相关方法在面向企业团队的系统教程里有完整拆解,可参考 /mall/ 上的 GEO 课程。