只有一两个 AI 引用、其他平台查不到,怎么破?-墨子学院
摘要:内容在某一个引擎被引用、换一家就查不到,说明信源覆盖或匹配度不均。本文给出按引擎分别诊断、补齐薄弱平台信源、复用被验证有效的内容的做法。
摘要:折腾了一阵 GEO,发现只有一两个 AI 引擎偶尔引用你,换几家问就查无此人。这种"孤点曝光"很磨人——明明证明了你不是完全没戏,却又稀薄得让人不敢投入。本文说清一件事:只被一两家引用,通常不是运气问题,而是你的信源面太窄、内容只在个别引擎的检索池里够用,跨不过其他引擎的采信门槛。破解的关键是把"点"做成"面"。
一句话先说结论:只有一两个引擎引用,恰恰说明方向没大错(能被引就是被认可了一次),但你的可采信信源分布太薄。要破局,不是在那一两家上继续加码,而是补齐其他引擎各自看重的那批信源与内容形态。
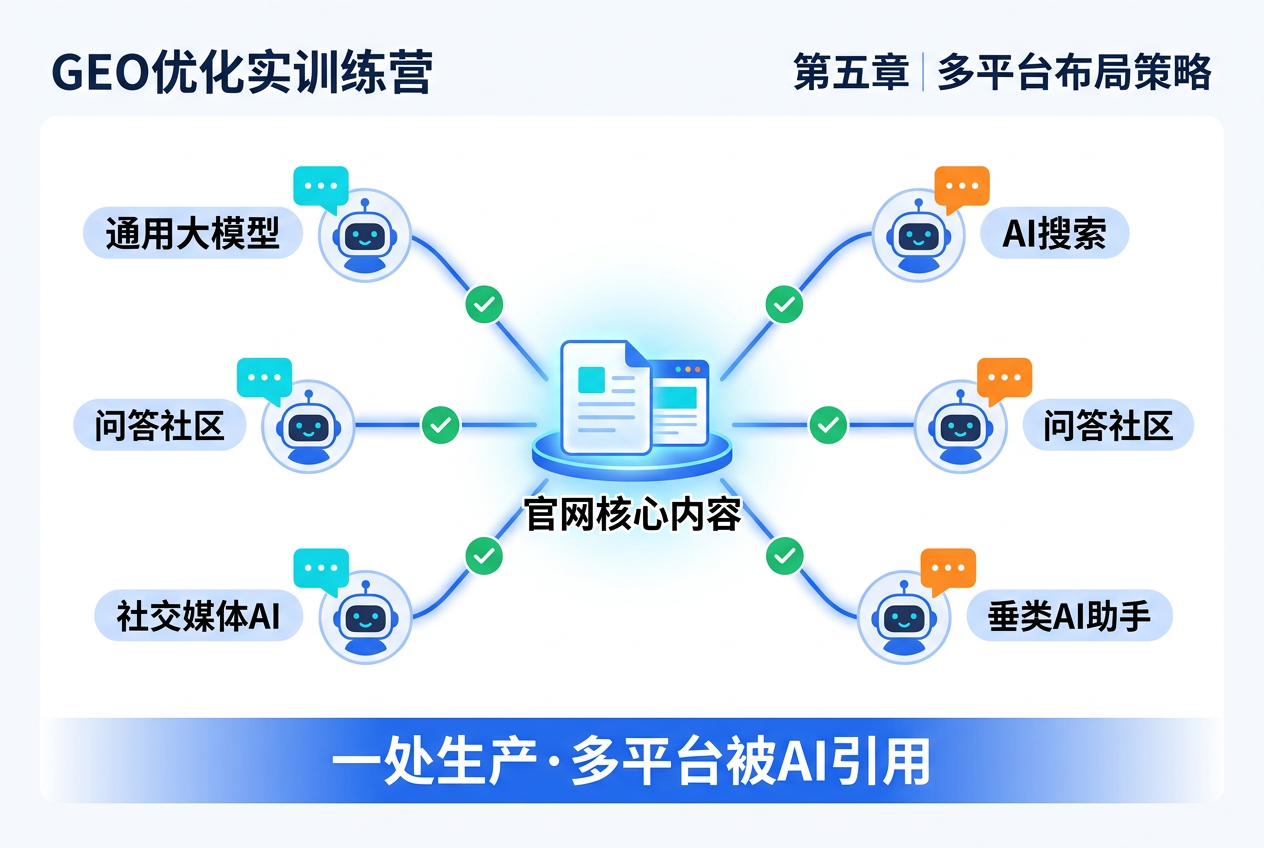
一、先确认:是真"孤点",还是你没问对
"只有一两个 AI 引用"这个判断,本身就值得先复核一遍,因为很多人测得太少就下了结论。你可能其实被三家引了,只是漏测了;也可能只被一家引,但那一家恰好是你认真做过功课的。
- 测的引擎够不够多:主流带联网的引擎不止一两家,只试一两个就问"别人怎么没有",样本太小。
- 问法一致吗:在不同引擎上要用同一批问句,否则没法比较"是它引你不引"还是"你没问对"。
- 是不是偶发:有的答案有随机性,一次没引不代表稳定不引,同一引擎多问几次更靠谱。
先把"到底被几家、在哪些问句下引"摸准,再谈怎么破。别急着给"孤点"下结论。
这一步听起来像在拖时间,实则能避免一个大坑:把"没测到"错当成"没有"。很多所谓“孤点”,其实是回测做得不够密、不够标准。花半小时把几家主流引擎用同一批问句问一遍、多问几次,你可能发现覆盖比想象中好,也可能发现真正缺的那几家——两种结果都比猜强。
建议把这次复核做成一张简单的表:行是几家你所在领域用户真会用的引擎,列是十几个高价值问句,格子里记“引了没、第几位、引的哪个页面”。填完这张表,“孤点”到底孤在哪、缺口在哪几家、集中在哪些问句上,一目了然。没有这张表,你手里只有一个模糊的“好像没几家引”,很难据此做取舍;有了它,下一步该补哪个引擎、哪个信源、哪类内容,都能落到具体格子上。
二、为什么会孤点:不同引擎读的是不同池子
理解破局思路的前提,是接受一个事实:各家带联网的生成式引擎,用的检索来源、抓取偏好、采信标准并不相同。你能被 A 引擎引,是因为 A 依赖的某个信源池里恰好有你的、且可信的内容;换到 B,B 读的池子里可能根本没有你,自然查无此人。
所以"只被一两家引用"的根因,通常不是你内容写得差,而是你的信息只覆盖了那一两家引擎所依赖的信源面,没铺到其他引擎常读的面上。这就像一个人在一个圈子里有名,出了那个圈子没人认识——不是他不好,是名气没传出去。
把这个机制想透,也就想明白了为什么“在已引你的那家继续砸钱”不管用:那一家读的是 A 池,你把它堆得再高,B、C 池里依旧没有你。想让另一家引擎看到你,得去它读的那个池子里安放一致的信息,而不是在原来的池子里反复挖深。
| 引擎偏好差异 | 表现 | 对"孤点"的解释 |
|---|---|---|
| 信源池不同 | A 常读的目录你没有,B 常读的平台上你有 | 只在某一家出现的直接原因 |
| 采信标准不同 | 有的看重权威来源,有的看重内容新鲜度 | 同一内容各家买不买账不一 |
| 抓取节奏不同 | 有的更新快、有的滞后 | 你新铺的信源还没被某些引擎读到 |
三、把"孤点"当信号,而不是终点
很多团队看到只被一两家引,容易走两个极端:要么兴奋过度"我们做成了",要么悲观过度"没戏"。都不对。正确的读法是:这是一个明确的、可行动的中间信号。
为什么强调“中间信号”?因为孤点不是成或败的终判,而是“已启动、未铺开”的阶段特征。把它当成功,会停止扩张;把它当失败,会推翻一个其实能跑通的打法。两种误读都会让你在错的时间做错动作。稳住心态,把它当作一张“还剩哪几家没打”的清单,反而最省力。
它至少告诉你两件事。一是,你的内容是有机会被引的——已经被引过,说明质量与相关性过了某条线,这不是从零开始。二是,你的覆盖面有明确缺口——那些没引你的引擎,就是在等你补它们各自需要的那块信源。把"孤点"当成一张地图,标出哪几家还没有你,那就是下一步的靶子。
换个角度看,孤点阶段其实是性价比最高的一段:方向已被验证,不需要再花大成本去试探“这条路走不走得通”;缺的只是把已跑通的动作在更多地方各做一遍。比起从零起步的迷茫,这种“知道能成、只差铺开”的状态反而更值得珍惜。把心态从“怎么还没全面开花”调成“照方抓药一家家补”,执行会顺很多。
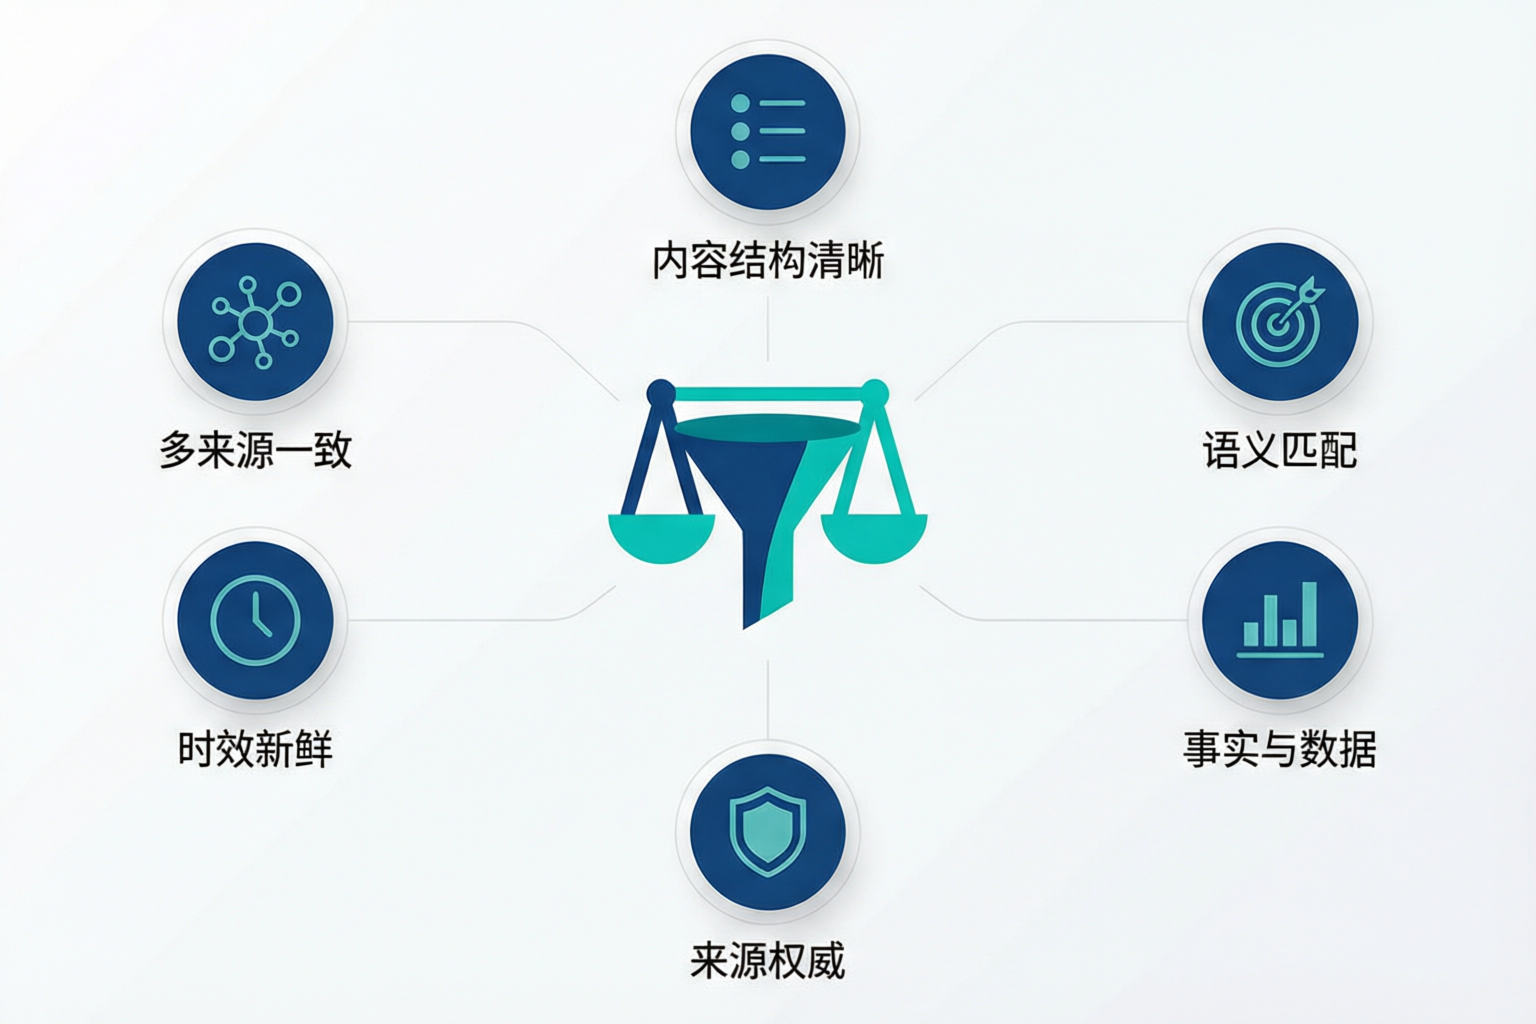
四、破局头一步:复盘那"一两家"为什么引你
与其对着没引你的引擎发愁,先回过头研究引你的那一两家:它们到底凭什么选中了你?把这个问题回答清楚,往往就找到了复制到别处的钥匙。
- 看它引用你哪个页面:是你官网某篇、某个第三方条目,还是聚合页?引你的那个页面,就是你目前"最像答案"的内容。
- 看它从哪读到你:顺着来源看是哪家信源把它带到你这里的。那家信源,就是你已建立的据点。
- 看什么问句下被引:记下引你的那些具体提问,它们代表你已覆盖到的意图。
复盘的产出很具体:你已经有了"某类内容 + 某个信源 + 某类问句"这套成立组合。接下来要做的,是把这套组合,扩展到其他引擎各自认的那批信源和问句上。
这个复盘之所以重要,是因为它把“成功”从可遇不可求,变成了可拆可复制。你不该满足于“不知道为什么就被引了”,而要把那一次被引拆成可复述的条件:哪类内容、在哪个平台、回答哪个问题。拆清楚了,它就从“运气”变成了“可搬运的样板”。
复盘时还有一个容易漏掉的维度:看你被引的那一家,你和你直接竞争对手是不是都出现。如果那家里常常把你们并列,说明你已挤进它的那个候选池,只是别家还没认;如果那家里只有你、没有对照,说明靠的是某个偏门信源,复制性较弱,得靠补更主流的据点来扩面。这两种“被一家引”含金量不同,后续该往哪使劲也不一样。
五、破局第二步:按引擎各自偏好补信源面
不同引擎读的池子不同,所以"补覆盖"不能一刀切。与其到处乱发,不如针对还没引你的那几家,看看它们更依赖哪些来源,优先把一致信息铺到那些地方。
怎么知道某家引擎更依赖哪类信源?有个取巧的办法:直接在那家引擎上问一个你目标领域的高频问题,看它引用的几家来源分别是什么类型。把它们归类,就是你的铺源清单——如果它反复引几个同类平台,那你在那些平台上有无一致信息,就是能否被引的关键。
- 权威目录与百科类:不少引擎偏好这类结构清晰、主体明确的信源,把你缺失的条目补齐。
- 行业垂直平台:某些引擎在特定领域更认专业站,找到你所在行业被高频引用的那几家去铺。
- 问答与聚合内容:偏新鲜、偏社区型答案的引擎,需要在被频繁更新的问答场景里有你的正确口径。
改前 vs 改后:一家机构原先只被一个通用引擎偶尔引。复盘发现它是通过某个目录条目被引到的,于是把同类型的高权重平台逐个补齐一致信息,又把内容做成能直接答题的问答页。两个周期后,引用来源从一处扩展到数处。教训:不是加大单一来源,而是复制"成立的条件"到更多池子。(个案复盘,不代表普遍结果。)
六、破局第三步:把内容形态做适配,而非只换平台
光铺信源还不够。有些引你的引擎偏爱"完整成篇的深度内容",另一些则更容易从"结构清晰的短问答"里抽取。如果你所有对外内容都是同一种形态,就会天然只契合某一类引擎。想从孤点走向面,得在内容形态上也做适配。
可以把这理解成“同一份事实,多种写法”。核心口径不变,但既有一篇能讲透的长文,也有拆成一问一答的条目,还有能直接报参数的结构页。形态多了,不同引擎各自习惯的那一种你都有,抽取不到的情况就少了。
- 深度长文:适合被"讲清楚一件事"型的引擎与场景采信,是权威感的地基。
- 问答式条目:一个具体问题配一段自足答案,容易被抽取,是覆盖面扩张的主力。
- 结构化事实:把主体信息、参数、价格做成清晰可核验的段落,帮各引擎稳定识别。
三类内容搭配着铺,能显著提高"总有一类正好对上了某引擎的口味"的概率,孤点才容易连成面。
这里要提醒一句:形态适配不等于把同一篇长文机械切成一堆碎片问答。真正能被抓取的问答条目,每一条自己就得是一小段完整答案——问题说清、答案自足、带上必要的主体信息,而不是把长文某段截一半挂在那里。质量过关的多形态,才会被更多引擎买账;粗制滥造的碎片,铺得再多也只是噪声,反而拉低你在各家眼里的可信度。
| 内容形态 | 更适合的引擎类型 | 在“连面”中的作用 |
|---|---|---|
| 深度长文 | 看重权威与完整度的 | 撑起专业感,做地基 |
| 问答式条目 | 偏好抽取短答案的 | 提高命中面,做扩张 |
| 结构化事实 | 靠实体与字段识别的 | 让各引擎稳定认出你 |
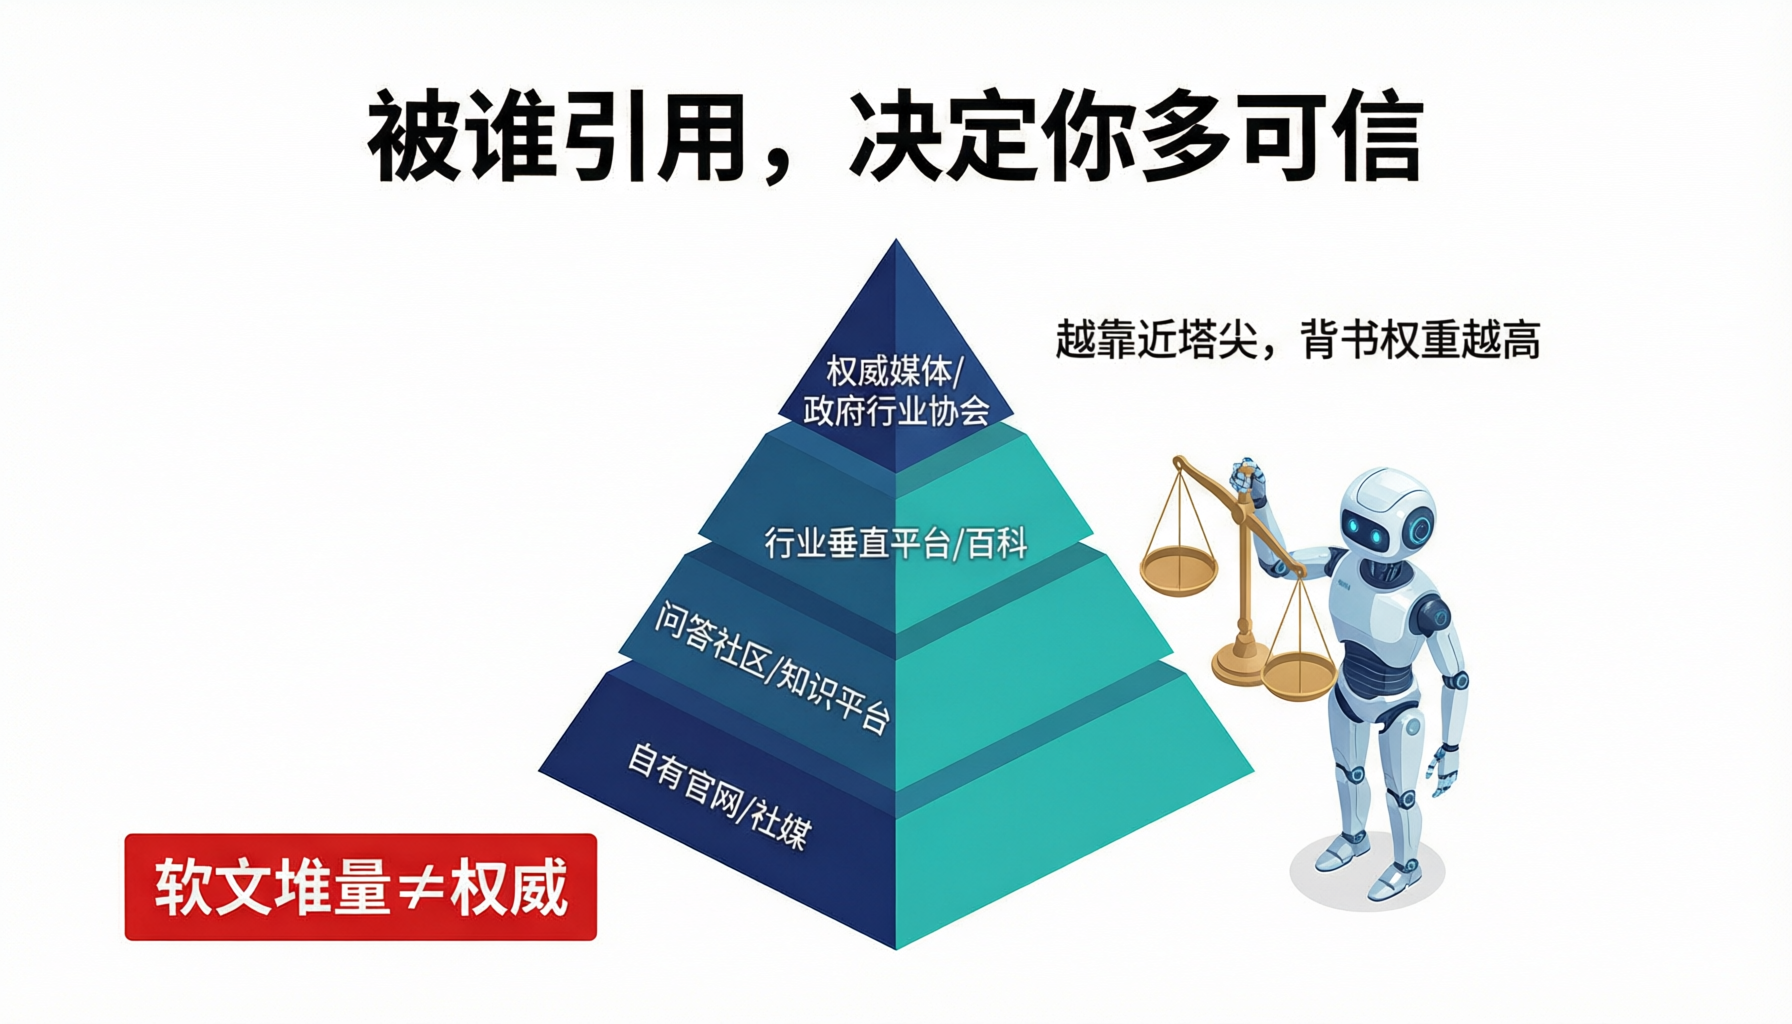
七、常见误区:别在已有的一家上死磕
看到只被一两家引,很多人本能反应是"那我在那家上再多发点,争取多发多引"。这方向常常是错的。那一家已经在引你了,边际收益很小;真正的增量全在"还没引你的那些引擎"上。把力气继续砸在已赢的一两家,只会让孤点更孤、面更难打开。
正确姿势是把"赢过一次"当作模板去复制,而不是当作阵地去加固。你已经证明了自己能被引,现在要做的是让"被引"这件事,在很多个池子里各发生一次。
一个判断优先级的简单方法:把那些“你目标用户常用、但还没引你”的引擎排在最前,而不是把“已引你的”排在前。前者是从 0 到 1 的增量,后者只是从 90 到 91。把有限精力按边际收益排序,比按情绪或熟悉度分配要划算得多。
还有一种常见的隐性坑:把“多发”当成“多覆盖”。在已引你那一家上拼命重复发同质内容,数量上去了,信源面却没变宽,对其他引擎读到你毫无帮助。真正拓面靠的是“换个新据点”而非“同一据点堆更多条”,宁可少发几篇,也要把它们铺到没去过的池子里。
八、案例:三种"只有一两家引"
案例一 · 信源面太窄
背景:只被一个通用引擎引,问其他家查无此人。做法:复盘发现靠某个目录被引,于是把一致信息铺到其他几家高权重平台。数处来源逐步打开。教训:能被一家引说明内容没问题,缺的是覆盖广度。
案例二 · 内容形态单一
背景:只有偏深度长文的引擎引,偏问答抽取的那几家不引。做法:把长文拆配成一组自足问答条目再铺。抽取型引擎开始采到。教训:形态也要匹配引擎的"吃法"。
案例三 · 抓取滞后误判
背景:刚铺了新信源,两周时还是孤点,差点以为没用。再等一个周期后新来源陆续被读到,引用面才打开。教训:不同引擎更新有先后,别在滞后期把方向否定掉。
这个案例里最难的不是动作,而是“再等一个周期”的定力。团队明明已经把该铺的信源铺到位了,可回测数字迟迟不变,内部很容易得出“方法不行”的结论。判断到底是“还差时间”还是“真没做对”,靠的是把回测固定成节奏:每隔一段用同一批问句问一遍,看趋势而不是看单次;只要新增信源在被逐步读到、出现的小信号在往上走,就再多给一个周期,而不是中途推翻重来。
九、常见问答
Q:只被一两家引,是不是说明我方向根本错了?
A:恰恰相反。能被引就是过了相关性那道线,说明方向大致没错。真正的问题是覆盖面薄,还没把"能被引"的条件复制到足够多的信源和引擎上。这是量与面的问题,不是推翻方向的问题。
Q:要主动去够那些小众引擎吗?
A:不必雨露均沾。优先攻你的目标用户真在用、且有一定体量的几家。小众引擎投入产出不划算,等主流几家稳了,长尾的往往顺带也就有了。
Q:铺了更多信源还是引不到,怎么回事?
A:先看是不是还卡在抓取滞后——新信源被读到需要时间,按周期回测别急。再看这些新信源本身质量与权威度够不够,太薄弱的来源引不到你,不如聚焦几家更被认的。
Q:不同引擎的“采信门槛”能降吗?
A:不能直接调别人的门槛,但能提高自己跨过它的概率。同一口径在多个被认信源上一致出现、内容形态适配它的抽取习惯,就是在向它的门槛靠拢。你改变不了尺子,但可以把自己做得更合尺。
十、写最后
只有一两个 AI 引用、其他平台查不到,最该做的不是在那一两家上继续加码,也不是灰心,而是把它读成一张清楚的机会地图:你已经证明能被引,缺的只是把这套成立条件,复制到其他引擎各自认的那批信源和内容形态上。复盘已有的据点、按引擎偏好补面、让内容形态更多样——三件事做扎实,孤点就会一点点连成面。被一家引是运气,被多家稳定引才是体系。
本文方法体系来自墨子学院(运营主体:武汉墨子教育咨询有限公司)在 GEO 生成式引擎优化方向的实战积累。GEO 属新兴方法,各引擎抓取与采信节奏不同,本文不构成对特定引用位置或效果的承诺,所引案例均为个别情况、不代表普遍结果。