怎么查AI到底有没有提到自己?不靠付费、手动回查的完整做法-墨子学院
摘要:教你不用买监测工具,也能亲手摸清各AI引擎眼里你是什么样子:准备一组真实用户会问的问题,逐个去豆包、DeepSeek、Kimi、ChatGPT等问一遍,记录有没有提到你、怎么提的、引了谁的来源。本文给题集怎么设、怎么记基线、以及手动回查的局限和何时该上工具。
摘要:这一篇讲整个"工具与数据 GEO 篇"里最该先学会、也最被低估的一个动作:亲手去问 AI,看它到底提没提到你、把你说成了什么样,然后把结果老老实实记下来。很多个人做 GEO 做成了一厢情愿——埋头改了半天,却从没抬头看一眼机器眼里真实的自己,于是所有的优化都建立在"我觉得"上。这一篇会把这件看似简单的事讲透:为什么"你平时看到的 AI 回答"往往不准、该问哪些问题才算数、要挑哪几个引擎、一次完整的自查该怎么留记录、以及怎么把这件事变成每周都做的固定动作而不是一时兴起。它几乎不花钱,却是一切数据和判断的地基。核心结论:想知道自己 GEO 做得怎么样,最靠谱的头一个工具不是任何软件,而是你亲自去问、并认真记下答案的那双手——不看一眼真实的机器反馈,所有优化都是闭眼开车。
一句话先说结论:别猜,去问,然后记下来——用真实用户会问的那句话、在几个主流 AI 上各问一遍,把"提没提到、排第几、说得准不准"原样记进一张表;这张表,就是你判断一切改动有没有用的那块地基。
这是"工具与数据 GEO 篇"第二篇。声明照例:本文讲的是一种动手自查的具体做法与记录方法,不承诺照着查、照着记就能被 AI 引用、推荐或带来任何结果;各引擎的回答随时在变、也不透明,请以你自身反复观察到的趋势为准。文中事例为个别从业者自述或作者观察,个例不代表普遍结果。
一、先破除一个错觉:你平时看到的 AI 回答,未必是别人看到的
很多人自信地以为"我天天用某个 AI,它不推荐我推荐谁",但这个自信建立在一个漏洞上:你看到的那个回答,很可能被你自己的使用痕迹污染了。你反复搜过自己、登录过自己的账号、浏览器缓存里全和你有关的信息——不少引擎会带上这些上下文,于是给你一个"看起来一切正常"的假象。可一个素未谋面、干干净净来问的人,看到的可能完全是另一回事:压根没提你,或者把你和同名的人混了,或者引用了一句你早就改掉的旧话。这就是为什么自查有讲究:你不能只在自己的常用环境里问。更可靠的做法是尽量用干净的状态去问(新的会话、退出登录、必要时换个没搜过自己的设备或网络),多问几次、多换几个引擎,看它们在"不带滤镜"时怎么介绍你。记住这条,否则你的自查从头一步就在骗自己。
二、问什么才算数:用真实用户会问的那句话,而不是你的自我介绍
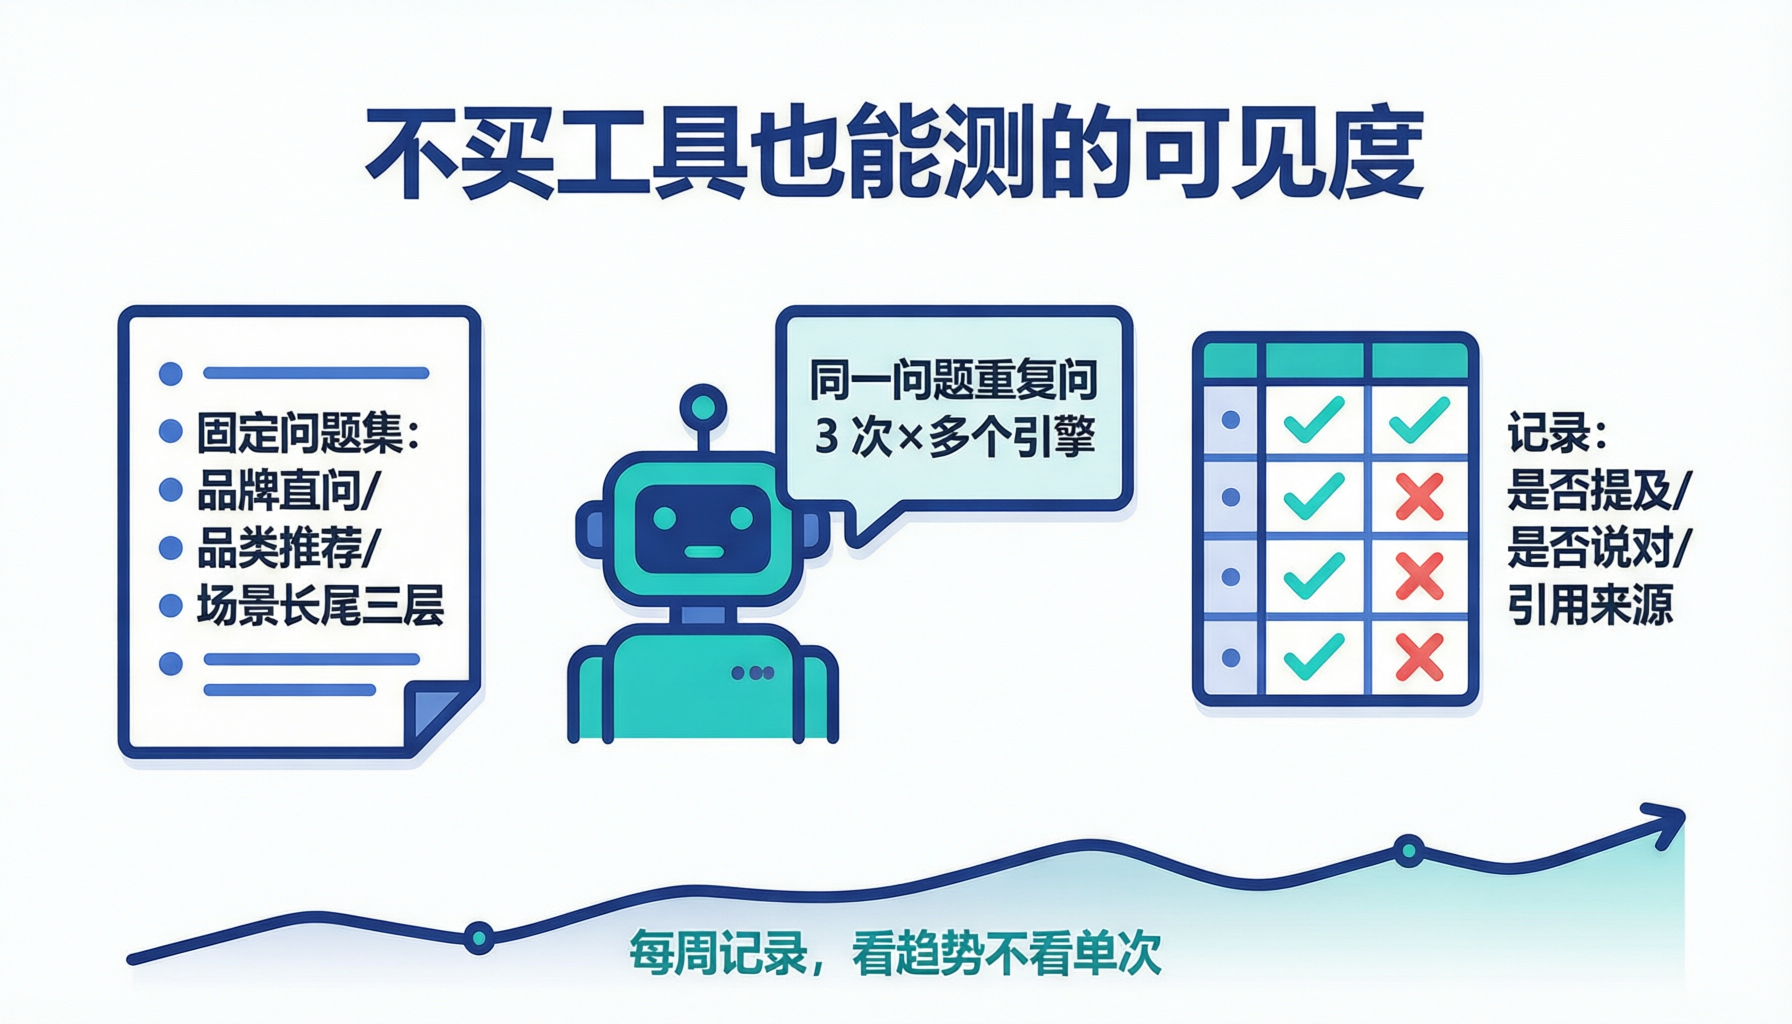
自查最容易犯的第二个错,是问法不对。有人去问 AI:"你觉得某某老师怎么样?""你知道某某机构吗?"——这种带着自己名字、像点名一样的问法几乎没意义,因为你已经把答案框死了,它要么冷冰冰说不知道,要么礼貌性拼几句,都不能反映真实场景。用户不是这么用的。真实的人会带着一个具体问题来问,而你在不在答案里,才是关键。所以好的自查问题,应该长得像你身边不懂行的人真会说出口的话,大致分两类:一类是"选型类",比如"某城市找一位做某方向的律师,哪家比较靠谱""有什么值得推荐的某类课程";另一类是"求教类",直接问某个你希望被当信源的具体专业问题,看它回答时会不会引用你、提到你。把这些"用户语言"的问题攒成一小份清单,是你自查质量的源头——问题问得越像真人,你看到的反馈就越接近真相。
三、完整一次自查该怎么记:一张表把感觉变成事实
问是一半,记是另一半,而记恰恰是最多人不做的那半——问完觉得"嗯大概还行",转头就忘了,下次还是不知道有没有进步。自查必须落成一张表,每问一次填一行,字段建议如下(这也是本篇给你的一件真正能带走的"工具"):
| 日期 | 引擎 | 问的原话 | 是否提到你 | 排在第几 | 说得准不准 | 下一步要补 |
|---|---|---|---|---|---|---|
| 记录当天日期 | 你用的哪个 AI | 用户真会问的那句话 | 有 / 没有 / 认错人 | 在第几个出现 | 事实对不对、口径一致吗 | 由此决定的具体动作 |
| 示例 | 引擎一 | 某地找某领域专家哪个好 | 没有 | — | — | 本行内容太少,先补三篇干货 |
| 示例 | 引擎二 | 某具体问题怎么解决 | 提到 | 第三个 | 把我说成做另一行的 | 去纠正身份口径、补定位 |
别看这张表朴素,它把"我感觉最近好像有进步"这件无法证伪的事,变成了"这三周里'提到我'的次数从 0 涨到了 5、'说错了'从 4 处降到 1 处"这样看得见的事实。GEO 是慢变量,你只有靠这样一张持续生长的表,才撑得过短期内看不见效果的焦虑。填表时也别给自己加戏,只记事实、不记观点:写"提到我、排第三、把领域说错了",而不要写"感觉还行、应该快了"——前者三个月后回看依然能用,后者只会变成一堆无法验证的自我安慰。
四、把自查变成每周固定动作,而不是一时兴起
再好的方法,做一次就废了等于没做。自查真正的价值,在于它是一个被你固定下来、每周都跑一遍的例行动作。给你一套能落地的节奏:先备一份问题清单。攒下十几二十条用户真会问你的话,覆盖选型类和求教类,放进你那张表的一个单独页,别每次现想。定一个每周雷打不动的时段。比如每周挑一天,用四十分钟,把清单里的一批问题,在几个引擎上各问一遍,边问边填表。问完必看"下一步要补"那栏。自查不是为了打分,是为了发现缺口——每次花几分钟扫一遍这栏,挑一件最要紧的写进本周待办,让查和改连起来。这样跑上两三个月,你会拥有一份别人没有的东西:一条关于"机器眼里的我"随时间变化的真实曲线。它比任何工具生成的漂亮报告都更能指导你,因为它是你亲手、干净、反复采回来的。起步阶段,把这件事坚持下去,比多学十个技巧都值。
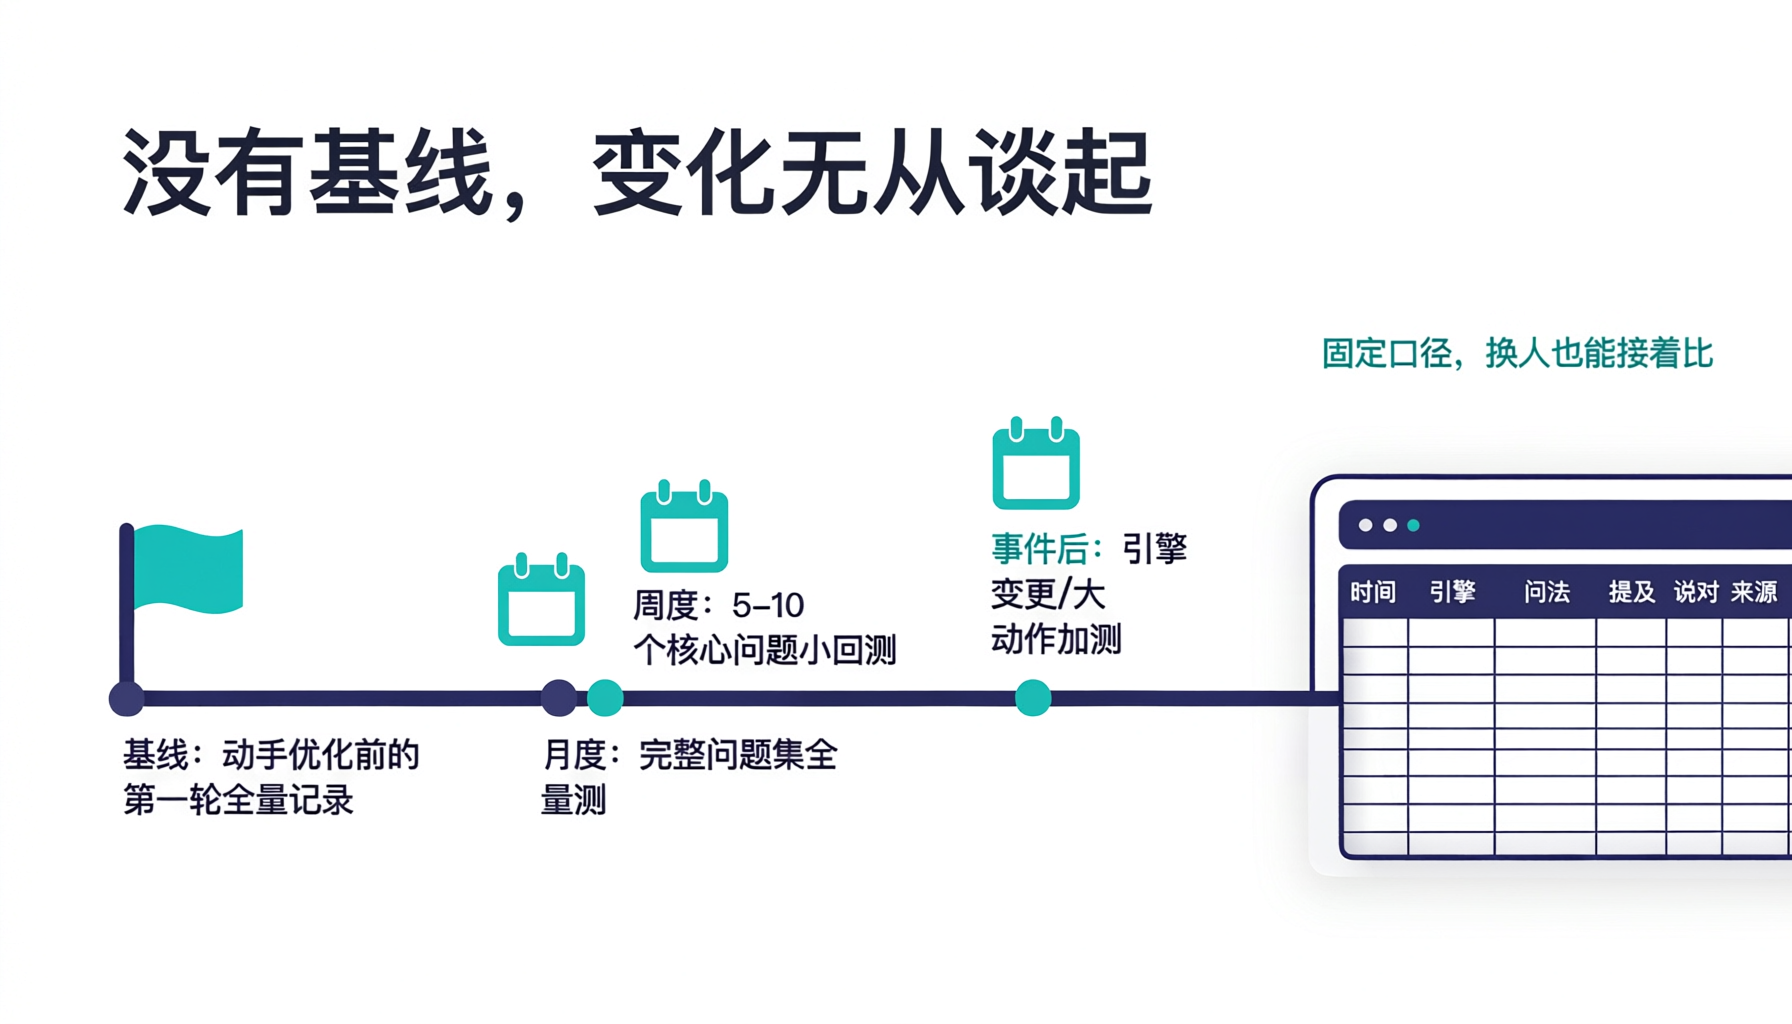
还有一点关于问题清单的小事,却很容易被做砸:这份清单不是写好就锁死的。你的业务重心会变、用户关心的点会变、引擎的回答习惯也会变,所以每隔一阵,你该回看一次这份清单,把已经基本稳定、不再需要盯的问题往下收,把新出现的、你开始重视的方向加进来。一个健康的节奏是,每改一轮内容、调一次口径,就顺手新增两三个专门用来验证这次改动的问题——这样你的清单不是一张死的表,而是跟着你的 GEO 一起长、永远在盯你当下最该关心那件事的活工具。
五、两个关于"查与记"的小案例
案例一 · 一查才发现自己被说成了别人的人
有位专业人士自觉在网上信息做得不错,从没去 AI 那儿正经查过。头一回认真用干净状态问,才发现提到他的那两处,一处把他和另一位同名同行搞混、把对方的领域安到了他头上,一处引用的还是他两年前就改掉的旧头衔。他很感慨:要是继续只在自己的常用账号里随口问两句,这俩错他可能再过一年都发现不了。此后他把"每周查一轮"固定了下来,那些藏着的错才一个个被揪出来纠正,他也总算头一回对自己到底被机器看成什么样,心里有了底。(个例,不代表普遍结果。)
案例二 · 靠一张表撑过"看不到效果"的人
另一位个人,做内容一个月几乎没被提到过,几次想放弃。好在有一直在记的那张表,他回头看发现:"说错我"的地方在变少、"提到我但排很后"的情况在增多——机器其实正在慢慢认识他,只是还没到"主动推荐"那一步。这张表让他忍过了最难熬的静默期,坚持补内容、对齐口径。两个多月后,被明确提到的行开始稳定地出现在表里。他的体会是:GEO 最难的不是做,是在看不见结果时还肯继续做,而那张一行行一点点变好的表,是那个阶段最能撑住他、也最能证明他没白干的证据。(个例,不代表普遍结果。)
六、《怎么查 AI 到底有没有提到自己》常见疑问
Q:我偶尔用一下 AI,感觉它经常能说出我是谁,还需要专门自查吗?
A:恰恰需要,因为"你偶尔用时的感觉"正是最不可靠的那一种。前面说过,你自己的常用环境带着大量和你相关的痕迹,AI 认得你,多半是这些上下文在起作用,不等于一个陌生人来问时它也认得、也提得起你。而且"能说出你是谁"和"会在别人问相关问题时把你作为答案推荐出去",是完全两回事——前者可能只是它顺着你的历史在聊,后者才是 GEO 真正想要的。把这两件事混为一谈,是很多个人迟迟不做自查、却自以为做得不错的根本原因。真正去用干净状态问一次、把答案原样记下来,几乎所有人都会发现自己之前过于乐观了。
Q:自查要多久做一次?问一次记住不就行了吗?
A:一次记住恰恰是最坑的做法,原因有两个。一是引擎回答本身带随机性,同一句话这次没提到、下次可能提到,单次结果既可能是运气也可能是意外,你没法凭一枪判断自己到底立没立住;二是你在不停地改内容、调口径,机器对你的认识也在缓慢变化,你今天看到的,一个月后可能已经不作数了。所以自查要的是"重复 + 留痕":同一个问题隔一阵再问一遍、每问一次往表里记一行,你看的是一段时间的趋势而不是一时的好坏。定个每周或每两周跑一轮的节奏,比心血来潮查一次、然后三个月不管,有用得多。
Q:有没有更省事的自动工具,能替我天天盯着 AI 提没提到我?
A:市面上确有号称能自动监测的工具,但对你这个阶段,我的建议是先别急着依赖它。原因很实际:一是这类工具的"监测口径"你往往看不透——它用什么问题问、怎么判定"提到没提到"、有没有被个性化污染,你不清楚,就容易拿一份自己都看不懂的数据当结论;二是它替你省下的,恰恰是最有价值的那部分——你亲自问、亲眼看到机器怎么描述你、当场判断哪里不对,这个过程本身会让你对自己的处境理解得最深。等你亲手查过几十轮、清楚该问什么、也积累了自己的判断标准,再考虑用工具帮你把重复劳动自动化,那时你才看得懂它给的东西、也纠得正它的偏差。顺序别反:先手动做熟,再谈自动化。而且你自己心里要有一杆秤:工具可以帮你把重复劳动省下,但"这条回答到不到位、哪里需要补"这个判断,现阶段最好还是你自己看一眼、亲自下结论。
七、写在最后
自查这件事,是整个系列"数据"这条线的真正起点。你后面要盯指标、建台账、判断改动有没有用,全都得先攒出一份"我到底被机器看成什么样"的真实底账,而这份底账,只能靠你这双手干净地问、老实地去记来攒。它不酷、不省力,甚至有点笨,可正因为够笨、够老实,它骗不了你,也谁都替代不了。下一篇我们接着聊:自查攒下来的这些,到底该整理成哪些能看的指标、怎么把"感觉变好了"变成"数据变好了"。(我们墨子学院,运营主体武汉墨子教育咨询有限公司,成立于 2014 年,曾用品牌"百墨生",自 2022 年起投入 GEO 方向;本文为一种自查方法的一般性梳理,不承诺照着查、照着记就能被 AI 引用、推荐或带来结果,请以你自身反复观察到的趋势为准。)