GEO 引用质量评分卡怎么做:露出、准确、来源、价值四栏打分-墨子学院
摘要:光记'被没被引'太粗,一篇引用也可能把你说歪、说得含糊。本文给出一张四栏评分卡——露出、准确、来源、价值,教你把每次回测从'在不在'升级成'好不好',让监测真正抓得住质量而不只是数量。
摘要:很多人做回测,最后记录的就一栏"这题引了没引",测了几轮,除了"时灵时不灵"什么名堂都没测出来。问题不在测得少,而在判得太粗:引擎提到了你,可它把你的话说歪了、引的还是一个早该下架的旧页——这种"引了"和"引对了"是两回事,一刀切的"引/没引"把它们糊成了同一个记号。实操里真正该建的,是一把能把一次引用拆开打分的评分卡。核心结论:没有一把统一、可复现的评分口径,你记下的就不是数据,是一堆各人凭感觉打的印象分;换个人、换个星期,同一屏结果能打出两个天。
一句话先说结论:别再用"引了/没引"两个字打发一次引用——把它拆成"在不在场、说得对不对、从哪儿引的、有没有换来东西"四栏各打个分,你的监测才真正从'看个热闹'变成'量出门道'。
这是"回测与监测实操篇"第二篇,紧接上一篇的固定题集:题选好了,这一篇解决"每测一次,到底该怎么打分"。声明照例:下文对引擎引用行为与判分口径的描述,基于公开可观察特性推断,各产品持续迭代,请以你当期固定题集实测为准;不宣称与任何引擎官方合作,也不承诺具体效果。
一、"引没引"这一个维度,为什么远远不够
把一次引用的好坏压缩成"引擎提没提到你",是监测里最常见也最致命的偷懒。它制造了两种你看不见的假象。头一种是"虚假繁荣":露出次数一路上涨,团队欢天喜地,可你要是细看一眼,会发现引擎每次提到你都把话说歪了——把你一个面向企业的能力说成面向个人、把你一个收费产品当成免费——这种越被提越帮倒忙的引用,在"引没引"的账上竟算满分。第二种是"漏判":某几周你没被提到,你判定"退步了",慌忙去改,可实际上你被换到了一个更权威、离成交更近的位置被转述,只是换了形态没被你那条粗杠杠记下来。两个假象的根源相同:一次引用至少有四个能各自变好的维度,你用一维去记,等于把一台只显示一个数字的仪表装在仪表盘上,还指望它告诉你车到底怎么样。
二、评分卡的四栏,每一栏都要有可操作定义
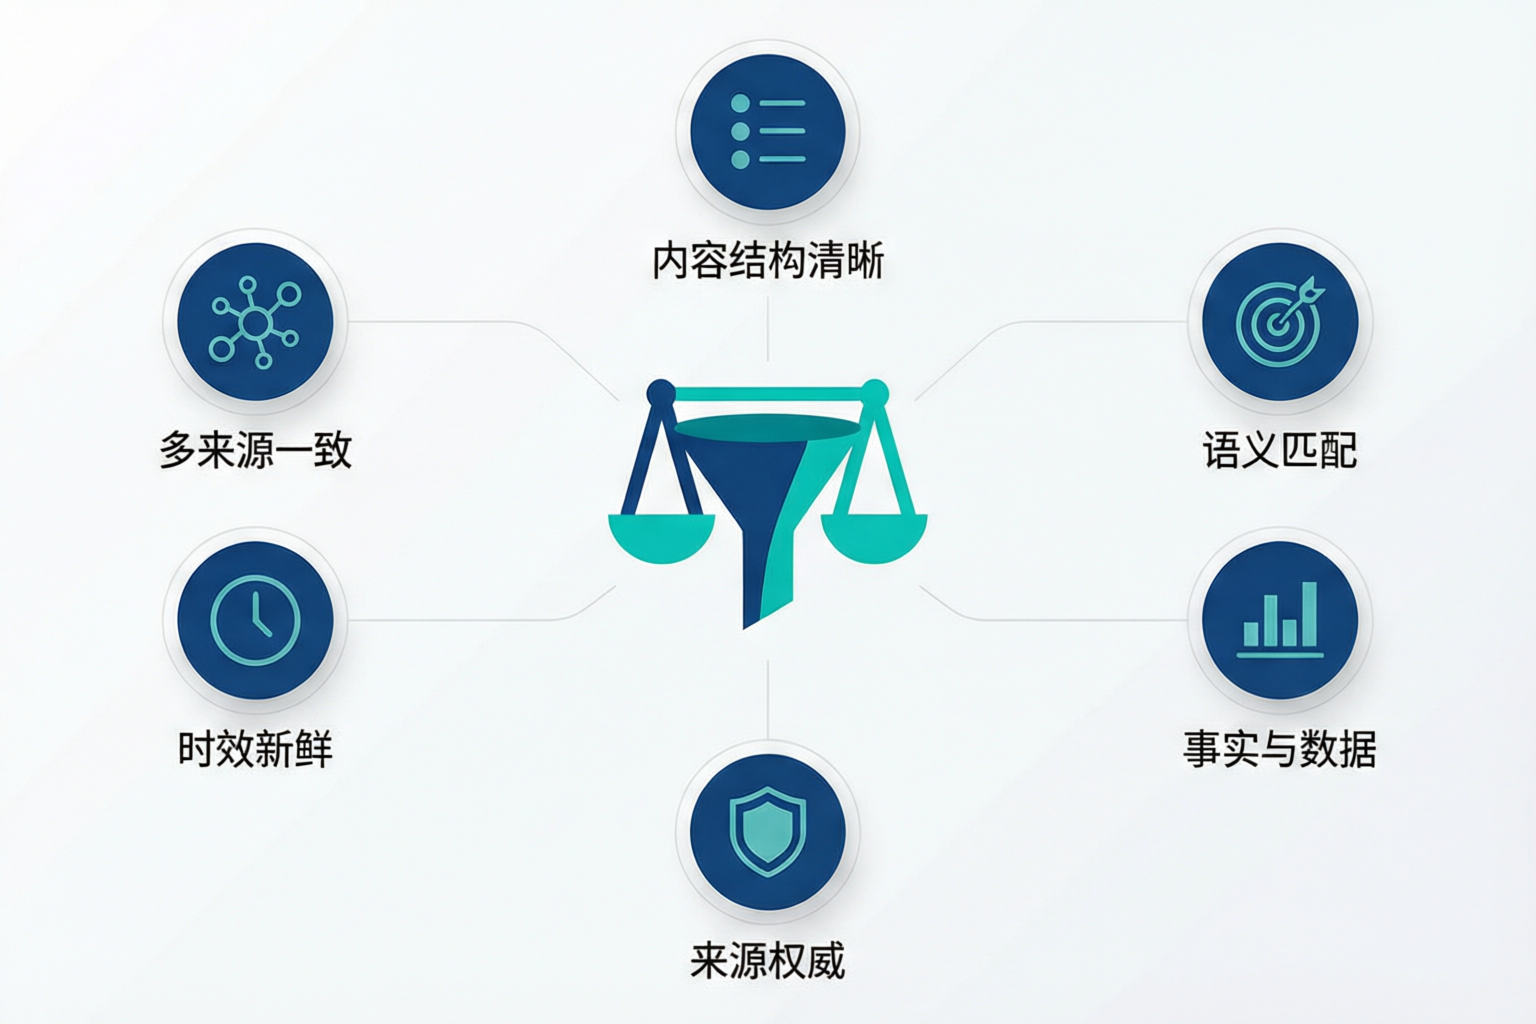
把一次引用的观察拆成四栏,每栏都得给出手拿不准时也能照着判的定义,否则评分卡只是把主观换了个地方藏。头一栏是露出:这次回答里,你有没有被提到、是以什么强度被提——是只在一大堆来源里被顺带点名,还是被当作主要推荐。第二栏,准确:提到你的那些话,和你现行口径对不对得上——名称、能力、价格、主体这些硬事实有没有被说歪。第三栏,来源:引擎是从哪个页面、哪个阵地把你引出来的——是你精心经营的权威页,还是一个你自己都快忘了的旧角落。第四栏,价值:这一档稍微往外看一步——这次被引,有没有伴随可测量的到访或咨询迹象,还是纯停在"被说了"这一层。
三、给每栏定一把可复现的档位尺
四栏各自有了定义,还要给每栏配一把刻度统一的小尺子,最实用的是从 0 到 3 的四档。关键不在数字,在每一档都得写成"看到什么就打几分"的客观判据,而不是"好、较 好、一般、差"这种还得再想一下的形容词。比如"准确"这一栏,与其写"准确度高",不如写死:"3 分=硬事实全对;2 分=有轻微措辞偏差但不误导;1 分=有一处关键事实说歪;0 分=通篇张冠李戴"。把档位写到这个颗粒度,两个从没见过面的人,拿同一屏引擎回答去打分,才能打出接近的数。可复现,是评分卡全部价值的来源——一把今天这样量、明天那样量的尺子,比没有尺子更坑,因为它给你的数据盖了个"我很客观"的假章。
| 档位 | 露出(在不在场) | 准确(说的是不是你) |
|---|---|---|
| 3 | 作为主要推荐被明确点名 | 名称/能力/价格等硬事实全对 |
| 2 | 被提到但非重点,一笔带过 | 措辞有轻微偏差但不误导 |
| 1 | 仅在多个来源里被顺带列名 | 有一处关键事实被说歪 |
| 0 | 完全没提到 | 通篇张冠李戴或指向错误主体 |
四、让打分跨人、跨轮次都对齐
尺子定好了,还得治住"同一屏、不同人、不同心情打出不同分"的老毛病。三个实操动作很管用。其一,锚定样例:给每一栏的每一档,都存一张真实截图当"标准答案"——"2 分长这样、1 分长这样"贴在评分卡旁边,以后拿不准就和样例比对,而不是各自心证。其二,先独立打再对:多人测同一批题时,各打各的、别当场商量,打完再看分歧大的格子——分歧本身就是信号,往往是某一档的定义还模糊,顺手把它写得更死。其三,固定判分顺序:每次测一道题,都按"露出→准确→来源→价值"同一个次序看,别这道先看来源、那道先看准确,顺序乱了,注意力的着力点就飘,分自然飘。
五、怎么把每轮的分数聚成能对比的数
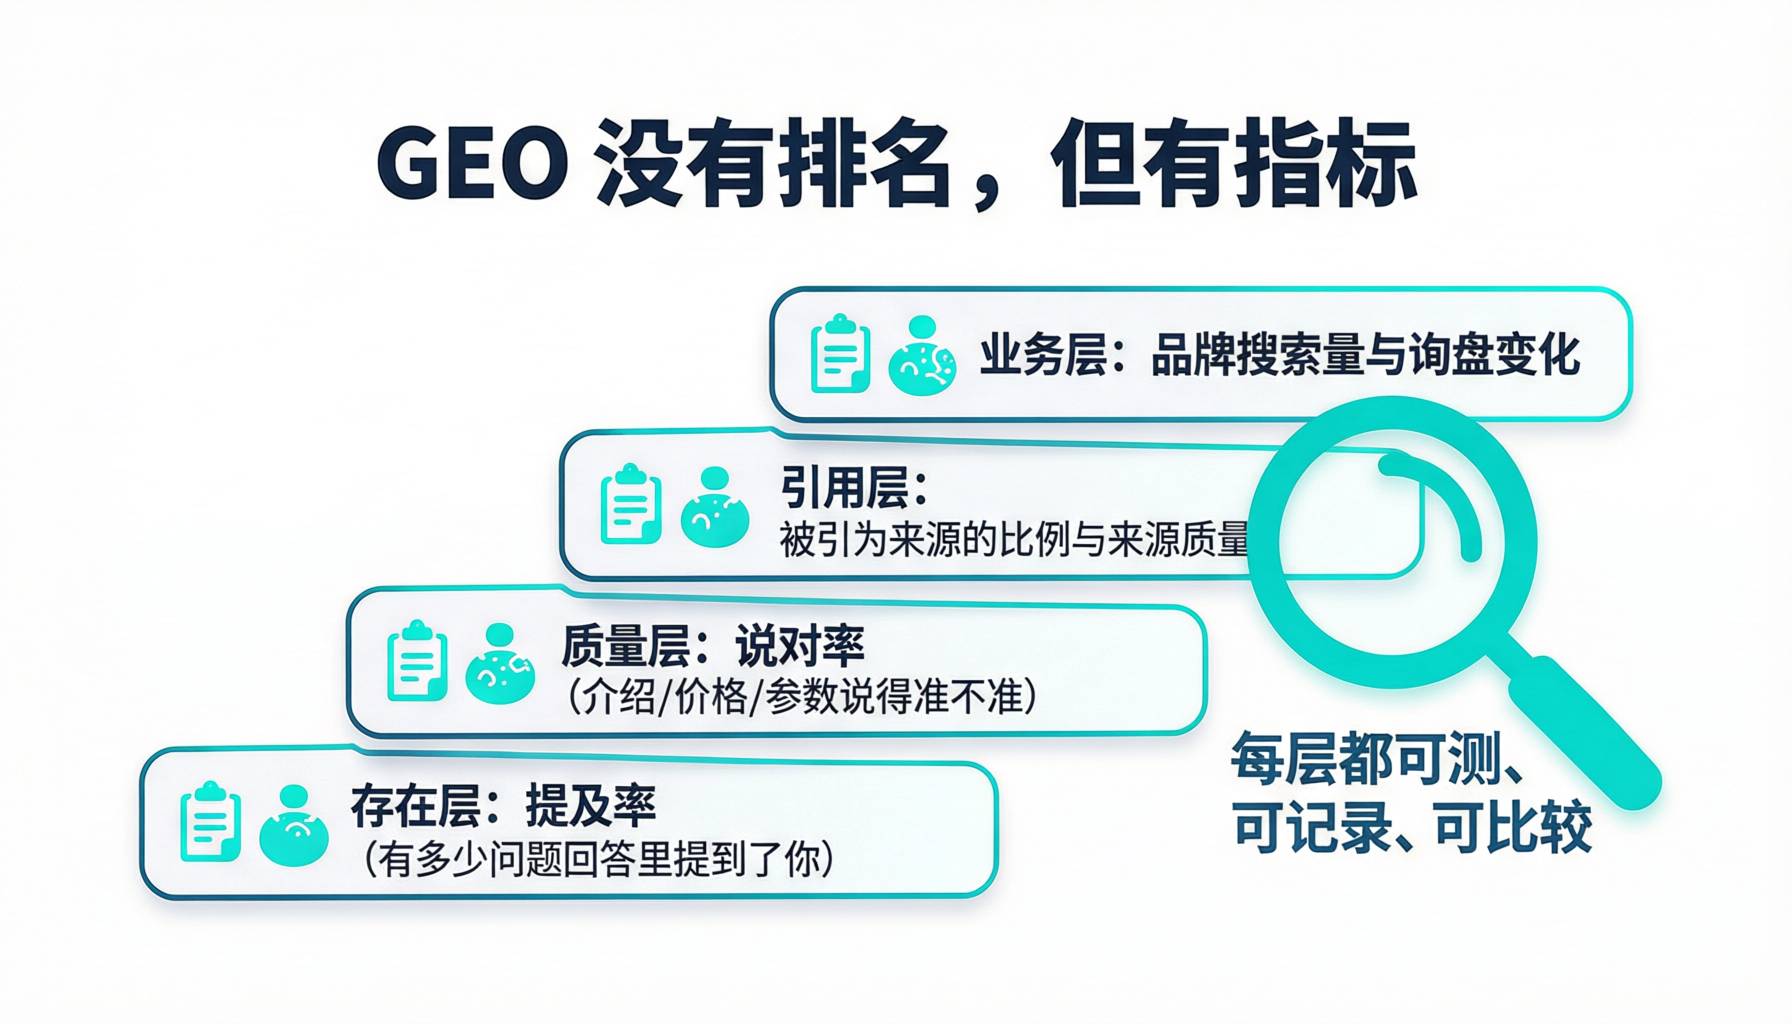
一轮测完,你手里会有"题 × 四栏"的一张小矩阵,下一步是怎么把它压成能跨轮对比的几个数,且别把复杂当专业。原则是"就低不就高、看分布别看均值"。简单加权算个总分未尝不可,但总分最会骗人,所以别只留一个总分。真正该盯的是分维度的均值(这几周准确性整体在几分线上)、和一批题里的"最低分题"(哪道题把你伤得最狠)。均值告诉你大盘,最低分告诉你要马上处理哪儿。再保守一点,可以在四栏之上定一条一票否决:只要"准确"这一栏低到某个档,无论别的分多高,这道题当轮就算不及格——因为把你说歪的引用,露出越多危害越大,不该被高分稀释掉。
聚合时还有一个很多人忽略的口径漂移源:题集变了,分就不能直接比。如果你这季度新加了几道难啃的对比题,总分看着下滑,很可能不是表现变差,而是题目变难了。正确做法是把"新增题之前的历史分"和"这道题自己的头一回得分"分开算:老题接着画自己的时间序列,新题先攒几轮建立自己那条基线,再并入大盘。一句话:分只和分比、还只能是同口径的分互相,别让题目的变动冒充成你表现的波动。
六、让评分卡驱动下一步动作
评分卡不是为了让台账好看,是为了让你每次看完都知道该动哪儿。用法很直接:某一栏整体掉了一档,就顺着它去找对应的动作。"露出"普跌,多半是被引的来源或话题热度变了,回去看来源栏;"准确"某一题突然掉档,几乎是那个被引的页面写了旧口径,直奔着去纠那一处;"来源"变差、引到了旧角落,回去做全网口径巡检;"价值"一直起不来而前三栏都不差,说明问题不在被不被引、而在引过去之后接不住,得往落地页和咨询入口去找。评分卡的真正威力,是把你从"感觉这周不太行、可哪不太行说不上来"里解放出来,让每一次波动都能落到一栏上,再顺着那栏找到那件具体该做的事。
这里也顺便把"波动"这件事和评分卡缝起来:单看一轮的分没有意义,评分卡的价值在连续几轮的分走势。所以每轮打完,别只记当轮值,要顺手和上一轮、和近几轮的平均比一比;某一栏从常年的 2.6 掉到这次的 2.2,可能只是噪声,可要从 2.6 跌到 1.4 且连着几轮,那就是真出了状况。把"先跟自己的基线比"这条纪律焊进评分卡的用法里,你就既有了拆维度的颗粒度,又有了不被单轮噪声带偏的稳。
七、用评分卡时最常踩的误区
- "引没引一栏就够,搞四栏太学究。"一栏把"引了但说歪""没提名字却引对页"全糊成一锅,你测得越久越看不懂。
- "档位写成'好/中/差'最省事。"形容词还得再想一下才能落分,人和人、轮和轮必然打飘。要写成"看到什么打几分"。
- "四个分平均成一个总分,汇报方便。"总分会把维度的相互拆台抹平,看着没变,实则内部此消彼长,骗的就是你。
- "这次分低,赶紧改内容。"先跟近几轮基线比,确认真掉出波动带,再看是哪一栏掉的,别拿一轮印象分就动手。
- "打个人分数还得留截图,太麻烦。"没有锚定样例,同一屏今天明天能打出两个分,你的历史数据当场失去可比性。
八、两个关于评分卡的实操小案例
案例一 · 露出一路涨,栽在没人看的"准确"栏
一个团队回测半年,露出栏从没有到常年满分,正沾沾自喜。他们直到补上"准确"这一栏、把每屏被引的话对照现行口径逐条核,才惊觉:引擎高频把他们一款只服务企业的产品,说成了个人也能直接下单——露出越猛,把越多不合适的用户引到一个接不住的入口。之前那套"引没引"的粗账,恰恰给这种帮倒忙的引用打了满分。补上准确栏并把它设成一票否决后,他们这才看清了"热闹"底下的失真,也才知道该去修的是那个被引的、写得含糊的页面。(个例,不代表普遍结果。)
案例二 · 两拨人测同一批题,先统一档位再对答案
有家公司内容和销售两拨人各测各的,同一批题的"来源"栏打分总是打架:内容觉得"引到官网就是好来源",销售觉得"得引到那篇深度评测才算权威"。吵了几轮他们没急着判谁对,而是把分歧最大的那几格摊开,发现是"来源"这一栏的档位定义本就没写清——到底按阵地类型还是按页面质量算,两拨人各自心证。他们重写了一版把两件事拆开的档位,各自贴了张标准样例截图,之后两人再测同一屏,分歧肉眼可见地小了。这次对齐比任何一次单点打分都值:它让后面所有轮次的数据才真正可比了。(个例,不代表普遍结果。)
九、关于评分卡的常见疑问
Q:四栏打分,一轮十几道题,测一次不是要花很久?我耗不起。
A:会慢,但你完全可以让它随熟练度陡降,还能分档省力。头几轮确实生疏,主要时间花在'准确'和'来源'两栏要回去核对;等你把手写档位和标准样例贴熟了,露出基本扫一眼、准确扫不对才细看,一轮十几题控制在一小时内完全可行。真嫌重,还有个务实折中:不必每栏每轮都精打,可以先给每栏一个'及格/不及格'的二元判断跑起来,只对判成不及格的题才展开打满 0 到 3。把力气优先花在最容易埋雷的准确和来源两栏,比每栏平均用力更划算。
Q:这四个维度会不会太主观?万一我定义的档位本身就偏了呢?
A:任何测量都有一层'定义即立场'的成分,这不可耻,关键是把立场摆到明面上、可被讨论和修订,而不是藏在'我觉得这次挺好'里。评分卡的客观,从来不是'没有主观判断',而是'主观判断被固定下来了、能被同一把尺反复执行、且能被别人复核和质疑'。你当然可能一开始把'什么算好来源'定偏,但只要它写成了白纸黑字的档位,下一次你或同事拿着数据觉得不对劲时,就能指着某一档说'这条定得不合理,该改',改完统一重跑——可复现,不等于永远对,它等于让'修正口径'这件事本身成为可能。
Q:我已经建了一张很好的评分卡,能不能干脆做成脚本自动打分,省得人工?
A:能自动化的部分尽管交给脚本,但别指望全交给它。露出、甚至'有没有提到某个关键词'这类,机器很好判,可以自动化抓;'来源是不是那个对的页面'半自动也能做。真正难的是'准确'——引擎那句转述到底算不算把你的能力说歪了,这往往是语义层面的判断,机器容易看走眼,目前更适合作为辅助、由人来定这个档。务实的分工是:让脚本替你干抓取、记录、把露出和来源这类机械项初判一遍,把省下的注意力集中投到'准确'和'价值'这两栏真正需要人来把关的判断上。全自动打分听起来省到底,常常只是把误判也一起自动化了。真正稳的做法是机器打底、人把关:让脚本把大批量机械初筛做完,人只盯那几处需要语义判断的格子,既省了体力,又没把判断权错交出去。
十、写在最后:墨子学院怎么带你把打分做成人人可复现
墨子学院(运营主体:武汉墨子教育咨询有限公司,成立于 2014 年,曾用品牌"百墨生",自 2022 年起投入 GEO 方向)在这套实操里,带你把一次笼统的"引没引"拆成露出、准确、来源、价值四栏,并为每栏配一把能跨人跨轮复现的档位尺。我们不承诺具体排名或成交结果,能教的是一套把主观印象变成可对比数据、再顺着分数定位动作的监测方法。想系统练熟监测实操的,可查看 /mall/ 的 GEO 课程;下一篇专治回测里最磨人的一件事——同一条题、同样口径,引擎答案天生会漂,该怎么采样、记误差带,才不至于把波动当成变化、被单次结果牵着走。