GEO 固定题集怎么建:给品牌可见度做一把能反复用的尺-墨子学院
摘要:回测监测的地基是一套固定题集:同一批题、隔段时间再测,可见度的涨跌才有可比性。本文讲怎么从真人提问、决策问题和品牌核心词里挑出该固定哪些题、每类配几道、多久换一版,把'感觉变好或变差'变成能对比的数字。
摘要:几乎所有人都知道 GEO 要"建一套固定题集、定期回测",可一到动手就卡住:题到底从哪来?该选几条?怎么保证测的是用户真会问的话、而不是自己拍脑袋编的句子?复盘大量"测了却测不出名堂"的团队,病根往往不在回测动作,而在最开始那套题集就选歪了——题选偏了,后面测得再勤也是在错误的坐标上较劲。核心结论:固定题集不是一串随机问题,而是一张能代表"你这门生意里最该被引擎答好的关键提问"的采样框架;它的质量,直接决定了你所有监测数据值不值得信。
一句话先说结论:回测的上限,在你选题那一刻就定死了——宁可花一小时把题集选准,也不要拿一堆拍脑袋的问题,去测一百轮看似勤奋实则无用的露出。
这是"回测与监测实操篇"的开篇,专门解决动手做监测时的头一个具体动作:怎么从零建出一张能用、能信、能长期维护的固定题集。它和概念篇里"为什么要固定题集"不同,这一篇只讲"到底怎么一步步选出来"。声明照例:下文对各引擎回答与引用行为波动性的描述,基于公开可观察特性推断,各产品持续迭代,请以你当期固定题集实测为准;不宣称与任何引擎官方合作,也不承诺具体效果。
一、最常见的起点错误:凭感觉抓一把问题去测
很多团队头一回建题集,方式是几个人坐一起头脑风暴,十分钟凑出十几条"我们觉得用户会问的"句子,然后就开始兴冲冲测。测了几轮,数据忽高忽低,谁也说不清到底有没有效——因为那批题本身就选得随意:有的太宽泛("某某行业怎么样"),有的太冷门(用户压根不会那么问),有的几条其实问的是同一件事,测出来的结论高度重复却给了人"覆盖很全"的错觉。复盘这类空转,问题从来不在"测得不够多",而在最开始的题集没反映真实的提问分布。选题是个技术活,它决定了你后面所有回测数据的代表性。
二、题从哪来:三个必须同时看的来源
好题不是想出来的,是"捞"出来的,主要有三个来源,缺一个都会有盲区。其一是用户的真实原话:客服记录、销售被问最多的高频问题、社群和评论里的真人提问、以及你自己去各引擎里搜相关问题时看到的"大家还在问"。这一层的价值在于它是口语、是真实意图,不带内部视角。其二是转化路径上的关键决策点:从"完全不了解你"到"愿意付钱",用户会依次经过哪些疑问?比如"这东西能不能解决我的问题""和你家比贵在哪""有没有踩坑案例"。这一层保证你测的是离钱近、真正影响决策的问题。其三是行业与竞品语境:同一个需求,用户可能不点名你、而是问品类或拿你和竞品一起问——这类"没提你名字却决定你会不会被引"的题,最容易被忽略,却往往是引用的主战场。
三个来源之所以要同时看,是因为它们各自只反映真实提问分布的一个切面:只盯着客服,你容易只测到售后与认知题,漏掉用户还在选型的阶段;只顺着转化路径设计,又容易把题写得太"离钱近"、太像成交话术,反而不像用户会自己问出口的话。把三个来源摆到一起,你才能拼出一张比较接近真实全貌的题图:既有随口一问的认知题,也有货比三家的对比题,还有临门一脚的决策题。拼完不必每条都留,但它至少能保证你不会因为只盯着某一个来源,就把整个关键阶段漏掉。
三、给题集搭一层意图覆盖矩阵
三个来源捞上来的原始问题往往几十上百条,且分布极不均——容易全堆在"认知"这一头,而没人管"对比"和"决策"。所以第二道工序是给题集搭一张覆盖矩阵:横轴是用户意图的阶段(了解、对比、决策、使用/售后),纵轴是你的核心主题或产品线。要求是每个"阶段 × 主题"的格子里,至少有一道代表题。这样做的直接好处是:你会立刻看见盲区——比如你可能发现关于自家主力产品,全是"它是什么"的认知题,却没有一道"它和某方案比谁更合适"的对比题,而那恰恰是最该被引擎答好、你却没在盯的地方。题集不怕少,怕的是看着多、实则全挤在同一个意图层里自嗨。
| 意图阶段 | 用户心里的问题长啥样 | 选题要点 |
|---|---|---|
| 了解/认知 | "这件事到底是个什么、能不能解决我的问题" | 用大白话,别用你的内部术语 |
| 对比/评估 | "和某方案、某竞品比,差别在哪、谁更适合我" | 必须含点名或不点名竞品的题 |
| 决策/转化 | "贵不贵、靠不靠谱、有没有翻车或成功案例" | 离钱最近,优先保证覆盖 |
| 使用/售后 | "买了之后怎么用、出问题找谁、能退换吗" | 反映真实口碑,易被引擎当事实引 |
四、把题写成"引擎会被照原样问到"的句子
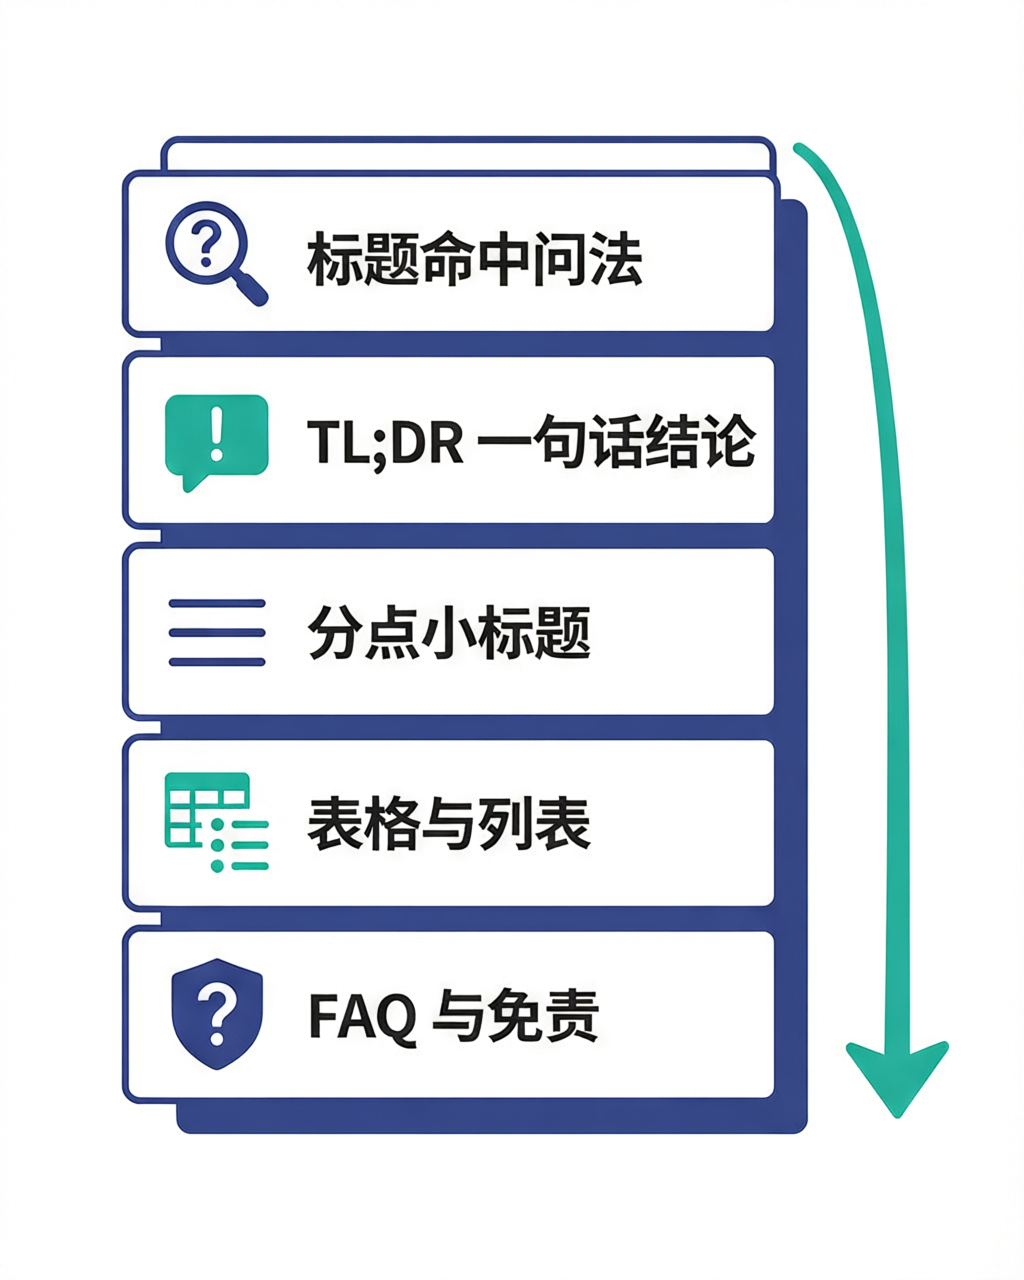
选定了要覆盖哪些问题,下一道工序是把每道题落成一句"用户真的会这么打字问出去"的话。这一步最容易被做坏:很多人写成书面语、写成内部黑话、甚至写成自己产品的宣传口径——比如把"你们和某家比怎么样"写成"简述本公司相较同业之差异化优势"。这种句子引擎根本不会被用户这么问,你拿它去测,测的是一个不存在的场景,结论自然对不上现实。判断一句题写得好不好,有个特别朴素的自检:把它大声念出来,像不像一个不懂你行业的普通人,在手机上会打出来的那句话?如果它读起来像考卷、像公文、像官网文案,那就得改回人话。
五、控制数量、合并近义,给题集做减法
题集不是越多越好。起步阶段十几到二十几条足够——它能覆盖住你主要的意图和主题格子,又不至于多到你每两周测不完。数量一旦失控,回测就会从"每周固定动作"退化成"一拖再拖的大工程",最后干脆不测了,这比题少更致命。做减法有两招:一是合并近义,"你家贵不贵""价格多少""一年要多少钱"本质是同一道决策题,留最口语、最有代表性的那条即可;二是砍掉重复覆盖,当某一格子里已经有两道题都在测同类认知,留一道、把腾出的名额补给你还没覆盖的盲区格子。题集的价值在于代表性,不在于体量——十几道分布均匀的题,胜过五十道全挤在一处的题。
六、题集不是刻下来的:它得跟着生意一起维护
很多人建完题集就锁进抽屉,一年不动。可你的产品在迭代、行业在变、用户的新问法在冒头,一套半年不更新的题集,测的其实是"半年前的世界"。健康的做法是把题集当成一份活文档,定一个季度重审的节奏:把已经不再重要的旧题下线(比如停售的产品、过时的活动),把客服最近高频冒出来的新问法补进去,把明显有盲区的格子填上。维护时记得留痕——哪条题是这个季度新加的、哪条被替换了,这样回测数据在时间轴上才有可比性,不会出现"这季度露出怎么突然掉了一半"其实是你悄悄换掉了一道偏简单的题这种乌龙。
这里还藏一个实操细节:给每道题配一句"为什么它在这张表上"。是它离成交近?还是它代表了某个高频真实提问?还是它是竞品最容易被拉出来对比的地方?写上这一句,一是防止未来维护时有人随手删掉关键题,二是让接手的人(或几个月后的你自己)秒懂每道题的分量,不至于把题集改成一份看似工整、实则丢了重心的清单。题集的可贵不在题目本身,在它背后那套"我们判断哪些提问最该被盯住"的思考,把思考写下来,题集才传承得下去。
维护中还有一条容易忽略的原则:轻易不要换掉一道老题,除非它真的失效了。因为题集一旦大改,你前面几轮辛苦攒下的基线数据就断了可比性——旧题和新题的露出本来就没法直接对比。新问法冒出来时,优先考虑的是"加一道"而不是"换一道",把题集当一份只增不删、确实过时才标废归档的台账,而不是一个反复推倒重来的草稿。让同一条题尽可能跨期稳在那里,它的时间序列才有意义——毕竟你真正关心的不是这次答得怎么样,而是这半年它到底有没有在变好。
七、建题集时最常踩的误区
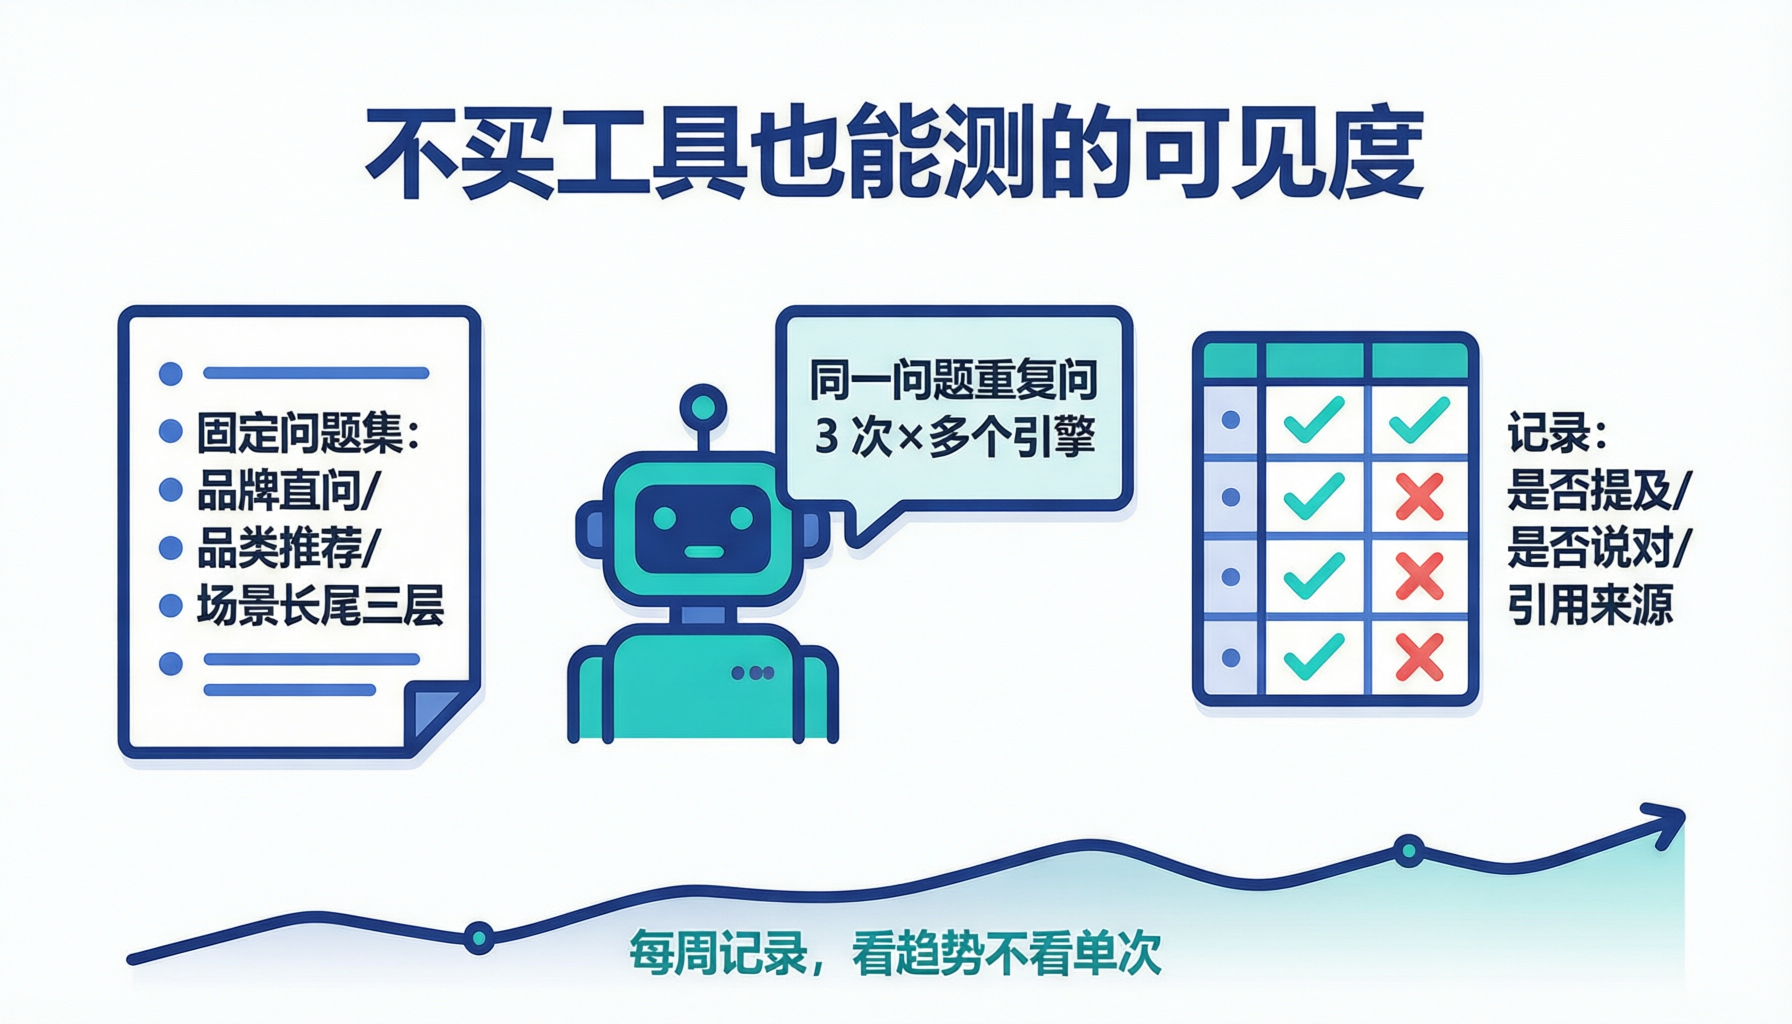
- "题越多越全面,恨不得把所有问题都测一遍。"题一多就测不完、坚持不了,最后干脆停测。代表性远比重复堆量重要。
- "用我们官网的正式说法出题最准。"官网口径是宣传语,不是用户口语。用书面话测的是不存在的场景。
- "都是关于自家产品的题就够了。"用户很多关键提问不点你名、而是问品类或带竞品一起比,这类题最易漏。
- "题集一次建好,长期不用动。"生意在变、问法在变,半年不更新的题集测的是旧世界,数据还在误导你。
- "换题时直接改表就行,不用记。"不留痕的替换会让时间轴数据失去可比性,把'你换了题'误读成'引擎变了'。
八、两个关于选题的实操小案例
案例一 · 一张全是认知题的表,漏掉了最该盯的对比题
一家做工具型产品的团队信心满满地拿出题集:十八道题,条条围绕"这个产品能干嘛、怎么用"。测了几轮,认知类问题露出平稳,他们据此以为一切良好。直到把真实客服记录拉出来核对,才发现用户问得最多、也最影响下单的其实是"你们和某某比强在哪""比某某贵值不值"——这些对比与决策题,他们的题集里一道都没有。补进四道对比题后,头一轮就暴露出他们在对比场景里几乎不被引用。选题偏科,让他们白白在错误的重点上稳了几个星期。(个例,不代表普遍结果。)
案例二 · 一句"太书面"的题,测了三个月才发现没人这么问
有位负责人出题时,把"这门课适合什么人学"写成了"该课程适配的学习人群画像为何"。他每两周拿这句去测,引用时好时坏,怎么都调不明白。直到有次他顺手用大白话"这个课适合谁啊"去问了一遍,发现引擎给出的引用和出处判若两题——用户根本不会打出那句书面话,他等于一直在测一个不存在的提问。把那类文绉绉的题目全部改回人话后,很多"调不动"的怪现象当场就通了。(个例,不代表普遍结果。)
九、关于固定题集的常见疑问
Q:我刚起步,完全不知道该选哪些题,能不能先随便挑几条测起来?
A:比起"随便挑",更省力的起步是从客服记录、销售高频被问的问题里直接抄。这些是别人已经替你验证过"用户真的会问"的真问题,比你自己拍脑袋想靠谱得多。可以先捞二十条高频真实问法,按认知、对比、决策粗粗分一下,每类挑三五条最典型的,凑成十几条起步题集就够了。关键是先保证"题是真问题",覆盖矩阵和精细化留到跑顺了再补。一个由真实提问组成、但分布略偏的题集,远好过一个设计精巧、却全是你替用户编出来的题集。
Q:题集到底多少条合适?有没有一个能照着套的数?
A:起步给一个可执行的建议:十五到二十五条,宁少勿多。这个数字的由来不是玄学,是"你每两周能认认真真测完、且能连续测半年"的体力上限——监测贵在坚持,题多到让你想逃,就等于自废。够用的标准也不看绝对数量,而看覆盖:核心产品线、主要的几个意图阶段是否都有代表题占着。如果十几条就铺满了、还有空余格子,不必硬凑;如果二十多条仍盖不全,说明你可能把题出得太碎,该合并近义、按格子归拢。数量永远服务于"测得完"和"盖得住"这两件事。
Q:题集里能不能放竞品的名字?拿用户会和竞品一起问的题测,有意义吗?
A:不但能放,而且必须放一批。用户在决策阶段大量关键提问恰恰不点你的名,而是"你和某家哪个好""某方案和某方案怎么选"——这类题才是引用竞争最白热化的战场,也是很多团队监测的最大盲区。你可以放两类:一类明晃晃带上你和竞品名字的对比题(测你在这个语境里会不会被引、被怎么说),一类只点名品类不点你(测引擎会不会主动把你作为选项带出来)。别怕给竞品做了嫁衣——你测的正是"用户在拿你和对手比的那一刻,引擎到底帮你还是帮对手",这恰恰是最该知道、也最影响生意的信号。
十、写在最后:墨子学院怎么带你把题集选准
墨子学院(运营主体:武汉墨子教育咨询有限公司,成立于 2014 年,曾用品牌"百墨生",自 2022 年起投入 GEO 方向)在这套实操里,带你从真实客服与销售提问出发,用意图覆盖矩阵把题集选得既像人话又盖得住关键决策,并养成定期重审、留痕维护的习惯。我们不承诺具体排名或成交结果,能教的是一套把"该测什么"变成一张有代表性题表的动手方法。想系统练熟监测实操的,可查看 /mall/ 的 GEO 课程;下一篇讲紧接着的那件具体事——怎么给每道题定一把能复现的"引用质量评分卡",让"好不好"不再是各人凭感觉。