GEO 数据误判的复盘:一张“效果很好”的截图,为何骗了团队三个月-墨子学院
摘要:面向引擎的效果判断天生高噪声,同题不同次问答案都会变,凭一次观察下结论代价极高。本文复盘数据误判这类坑:偶然露出当成规律、单张截图当证据、异动就大动干戈。核心是承认噪声,用固定题集攒基线、多轮采样、给每次改方向设一道最少证据门槛,先问波动再问变化。
摘要:GEO 决策里最常见、代价也最高的误判,是用一次观察下一个结论:某条内容偶然被引了,就宣布找到了规律;某张截图里品牌露了个脸,就向上汇报"效果很好";某周数据掉了,就慌忙推翻整套做法。复盘这些坑,病根往往不在数据太少,而在太急——把还没排除波动的单次信号,当成了可以据以决策的趋势。核心结论:面向引擎的效果判断,天生是高噪声的:同题不同次问答案都可能变。在这种噪声里,能救你的不是更敏锐的直觉,而是一套固定题集、多轮采样、先问波动再问变化的笨办法。
一句话先说结论:在引擎这种噪声极大的场里,一个数据点是故事,三个以上带波动的数据点才是证据——凭一张截图拍板,和在赌场看眼牌就下重注,用的是同一套要命的直觉。
这是"案例复盘与踩坑篇"第六篇,专讲数据误判。它和上一篇追攻略看似两回事,其实是同一种病的两面:攻略是别人的误判,截图是自己的误判。而人对自己亲手抓来的那张"好结果",往往比对别人的话更深信不疑。声明照例:下文对引擎回答波动性的描述,基于公开可观察特性推断,各产品持续迭代,请以你当期固定题集实测为准;不宣称与任何引擎官方合作,也不承诺具体效果。
一、一次复盘:一张"效果真好"的截图,骗了团队三个月
一个团队在某引擎上做了次优化,负责人抽了个顺手,测到一条自己的核心问题被满段引用,截图发到群里,士气大振,据此又追加了不少预算。此后三个月,他们一直用这张截图当作"这条路走得通"的证据。直到有人提议正经建个回测表,把那条题连着测了几轮,才发现它其实是低概率的好结果——同一条题反复问,十次里也就两三次能引到他们,多数时候并没有。那张让全群振奋的截图,恰恰抽到了运气最好的那一次。复盘这一坑,最痛的不是白花了预算,而是他们曾经离真相很近:只要当时多测几轮,就不会被一张截图牵着走三个月。误判的代价,常常源于"测一次"就下结论的急切。
二、误判的四张面孔
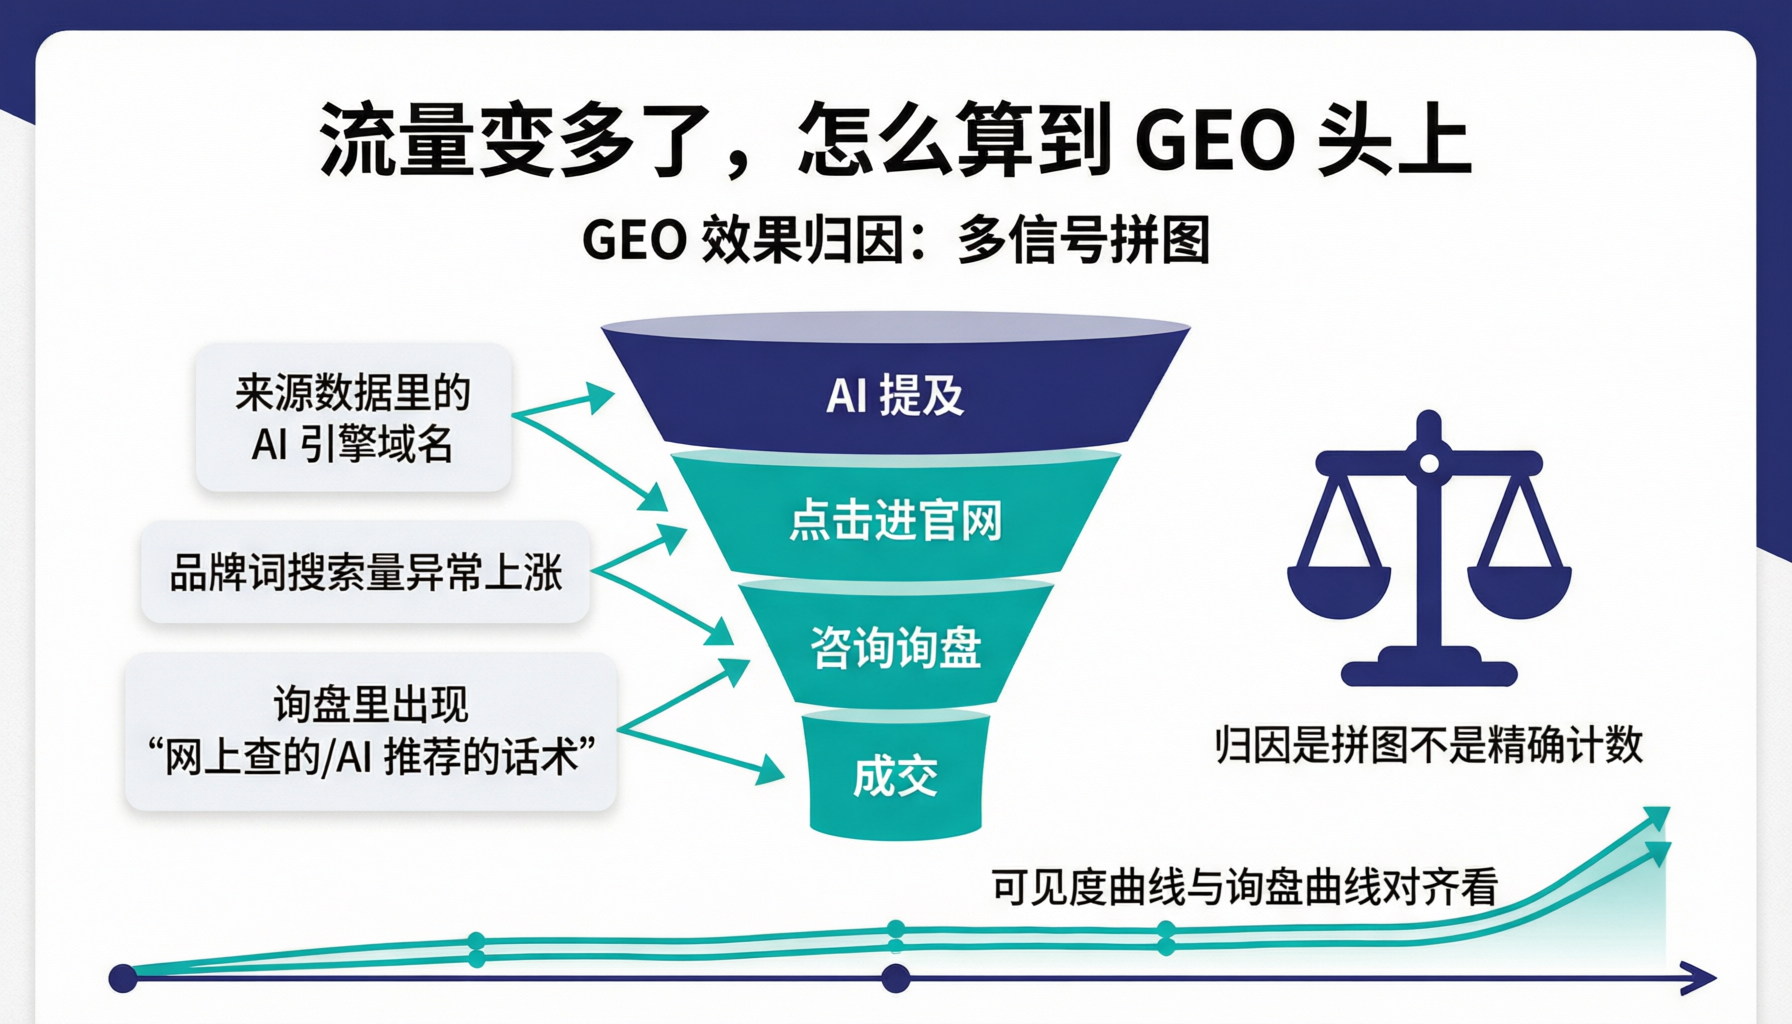
数据型误判翻来覆去就那么几种。其一,以偏概全:一次好、一次坏就定性,无视引擎回答本身的波动区间。其二,指标错位:盯着"露出次数"这种看着热闹的数字,却不管它引的准不准、带没带来任何实质到访——露得多但每次都说歪你,比不露还糟。其三,幸存者截图:只留下对自己的决策有利的那几张证据,对自己不利的默默忽略,团队里传阅的全是捷报。其四,归因过强:这周涨了,直接归功于上周那次改动,却没考虑季节、热点、引擎自己改版这些你没动的变量。四张面孔背后是同一个心理:人天生厌恶不确定,急着从混沌里抓一个"因为所以"让自己安心。可在高噪声的领域,这种急,恰恰是最大的风险。
更值得警惕的是,这四种误判很少单独出现,它们会彼此加强。一张幸存者截图一旦进了汇报,就给“以偏概全”发了通行证;而大家都盯着露出次数,归因时又自然把上涨归给最近那次改动。于是一个本来站不住的信号,在团队的互相背书里被打磨成了“共识”,直到某天预算花大了、方向跑偏了才暴露。误判真正的杀伤力,不在某一个数字看错,而在看错的人凑在一起,把一个噪声供成了共识。
三、先问波动,再问变化:给误判装一道刹车
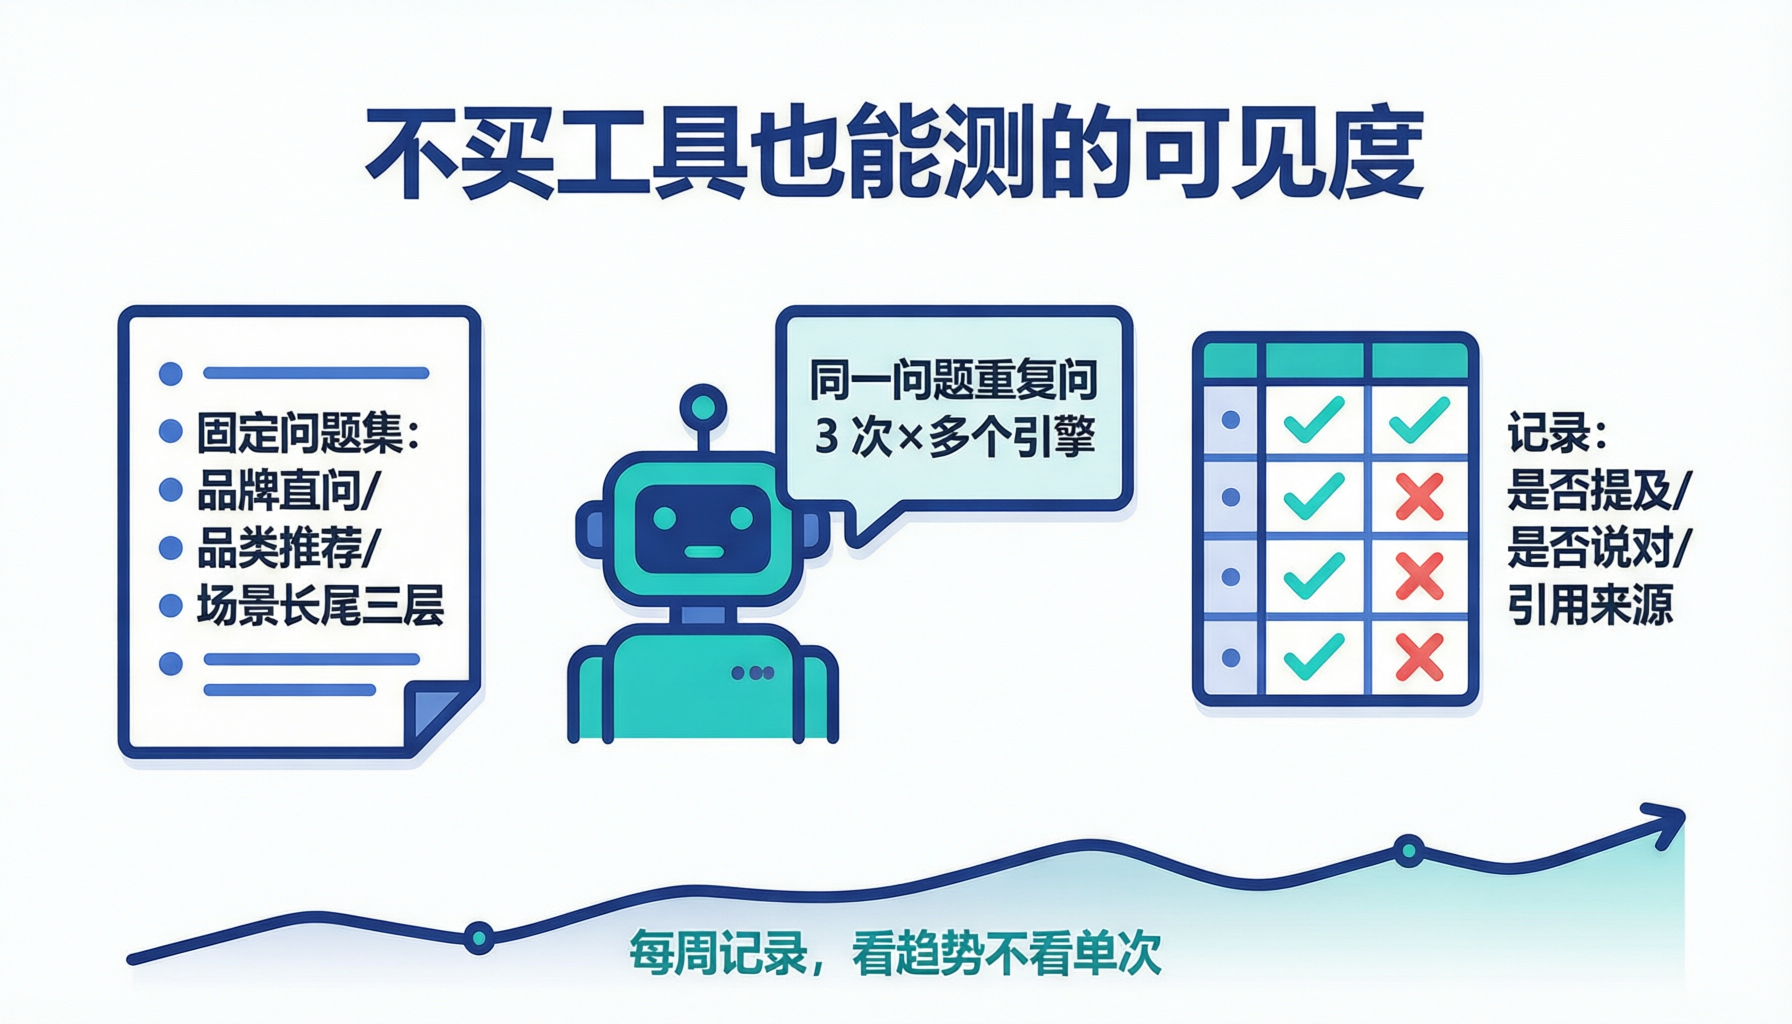
防住多数数据误判,靠的不是更聪明,是更笨、更守规矩。一个特别有用的思维顺序是:看到任何"变了"的信号,先别急着归因,先问它有没有超出平时的波动。怎么知道平时的波动?靠固定题集、按同样口径反复测攒出来的基线。有了基线,你就有了那把尺:某条题从平均 6 次引到变成这次 8 次,很可能还在正常波动里,不值得大惊小怪;可从 6 掉到 2,且连续几轮都低,才大概率是真出了状况。没有基线,你手里每个数字都是孤零零的,好也慌、坏也慌,决策全凭情绪起伏。所谓数据素养,在这个场景里说白了就是:先确认这是信号还是噪声,再决定要不要为它行动。
麻烦的是,基线本身也需要时间去堆。很多人卡在“我还没基线,难道就什么都不能判了吗”——不是。没基线时更要守住的是一条底线:把重大决策的阈值调高。没尺子时,只有那种明显跳出常识、连续几轮一致的情况才值得动手;那些“看起来好了一点”的模糊信号,基线没建起来之前一律先存着、不据此改方向。这样你至少不会在最没把握的时候,做出最贵的误判。基线不是“有了才能开始”的前置条件,而是“边测边长”的副产品——你只需从今起把每次观测记下来,几周后那把尺自己就长出来了。
| 看到的"现象" | 冲动解读 | 更稳的解读 |
|---|---|---|
| 某次测到被满段引用 | 我们成功了,追加预算 | 多测几轮,看这是常态还是抽到上沿 |
| 这周露出比上周高 | 上次的改动见效了 | 先对比波动区间,再谈是不是变化的功劳 |
| 某条题突然掉出 | 被限流了,赶紧改 | 先确认不是单次抖动,再看是否连续几轮真低 |
| 露出次数一路涨 | 趋势大好 | 查引的是不是对的、准不准、有没有带来实质 |
四、指标别只数露出,要数"有没有用"
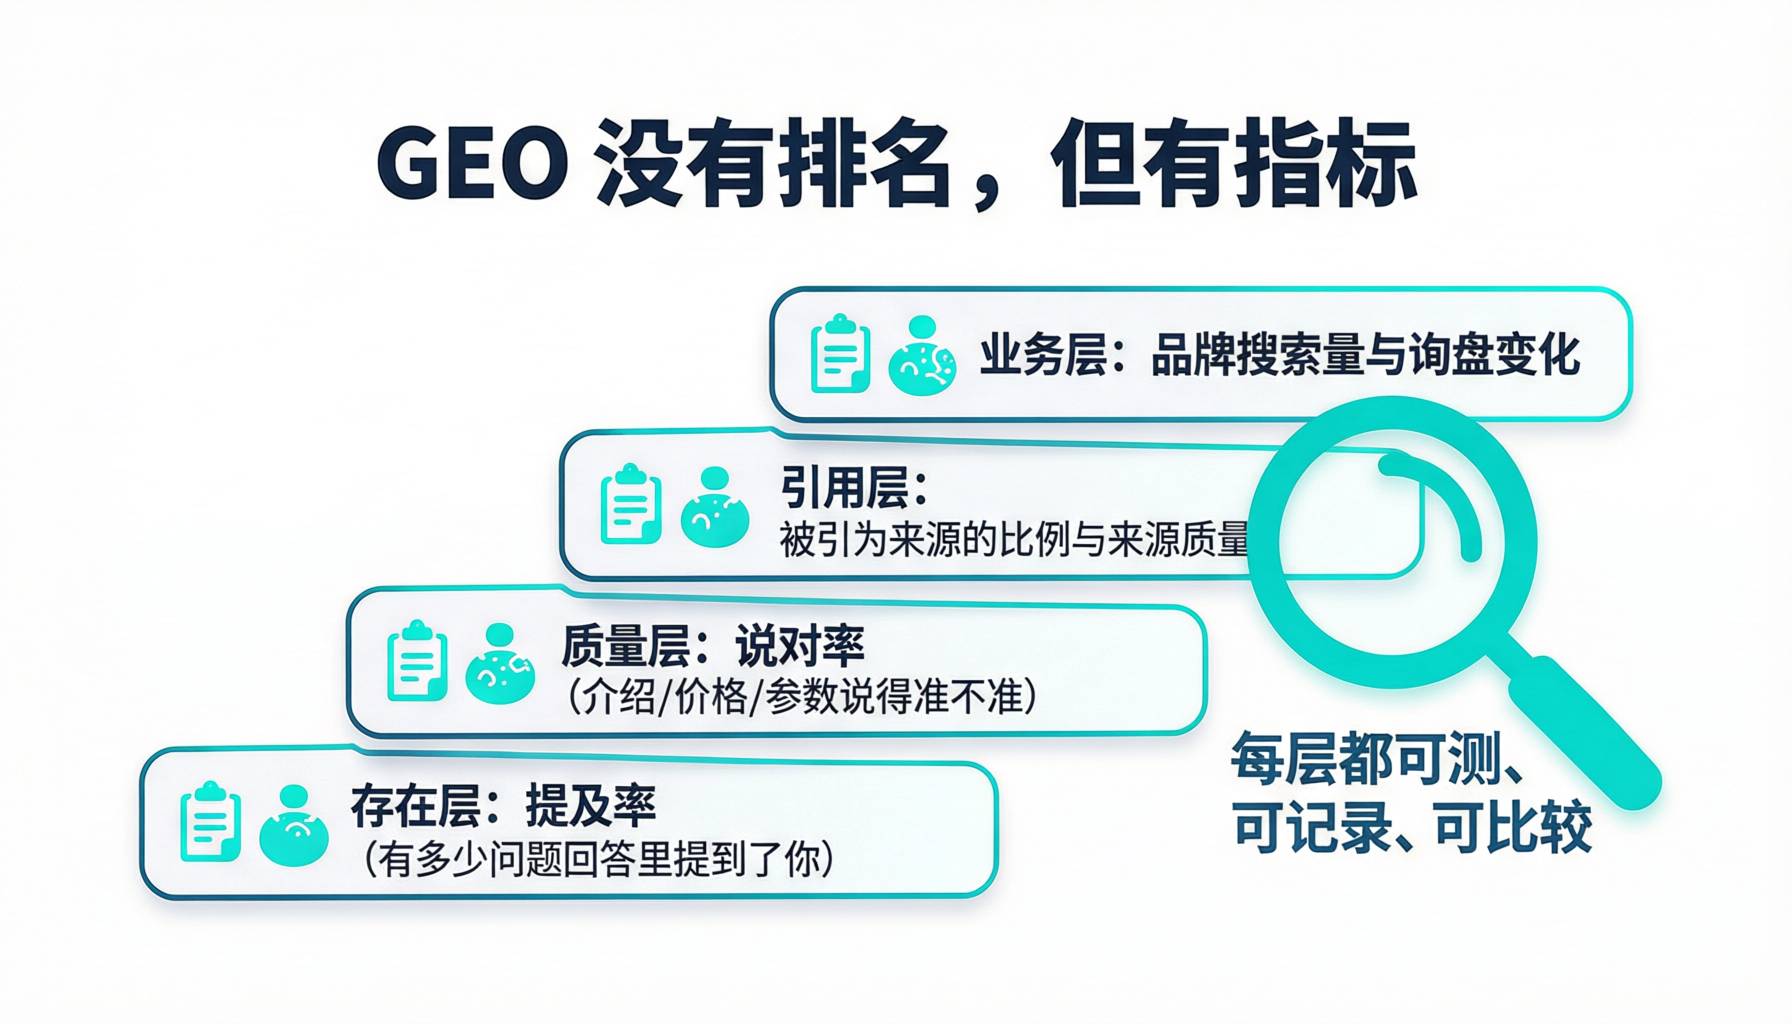
误判常常不是数错了,是数错了东西。只看"引擎提没提到你"这一个维度,很容易养出一堆虚假繁荣:你被提到了,却每次都被说错;你露出了,却引的是一个早该下架的旧页。复盘时应把观察的颗粒度做细,同时看几件事:提没提到(露出)、说得对不对(准确性)、从哪个阵地引的(来源)、能不能带来可测量的到访(价值)。四个一起看,才能识别那些"露得多但没用"甚至"露得多还帮倒忙"的情况。单一指标最大的陷阱,是它给你行动的正当性,却不告诉你行动的方向对不对——你越努力优化那个数字,可能离真实目标越远。
这里要补一句现实里的难点:多列一起看,难免遇到“几个指标互相拆台”的情况——露出涨了但准确性降了,来源变好了但没带来到访。很多人一碰到打架就退回只看一个数,图个心安。可对的方向恰恰相反:指标打架本身就是最有信息量的信号,它在提醒你“你以为的一个进步,可能是按下葫芦浮起瓢”。这时该做的是回到你真正想要的那个结果(而不是任一个代理指标)去定优先级:如果目标是被准确引用,那“露出涨、准确降”就不是好事,得停下来查是不是为了多露而把话说松了。把代理指标和真实目的之间的那根线时时握住,才不会优化着优化着,跑到了自己谁都不认识的地方。
五、给决策设个"最少证据"门槛
制度化的防误判,是给"我要为一个数据改变决策"这件事设一道最低证据门槛:任何单次观测都不许直接触发行动,必须先复测、必须达到你事先定好的样本量、必须超出基线波动,才升级成"值得据此调整"的结论。这道门槛听起来拖慢决策,其实是省下了最贵的成本——错误方向上的一路狂奔。你会发现,一旦给团队立了"截图不算证据、至少几轮复测才算"的规矩,那些凭一时兴起就大改方向的事会明显减少,讨论也会从"我觉得有效"变成"我们测了几轮、波动多大"。把判断标准前置、写死,是对抗人性里那份急躁最省力的办法:你在冷静时替冲动的自己,预先设好了闸门。
这道门槛还要防住一种更隐蔽的误判:选择性执行。人会不自觉地对自己的"好直觉"放宽标准、对不利的数据从严质疑——被引那张截图,"一次就够了吧";掉了那次露出,"可能是它抽风,再看看"。要破这个双重标准,最有效的办法是把门槛写成对所有人、所有方向都一视同仁的硬规则:无论涨跌、无论这结果对你有利还是不利,都要走同一套复测和基线比较。规则一旦允许"这次情况特殊"地绕开,它就不再是规则,而成了替你的情绪背书的橡皮图章。防误判的难点从来不是不懂,是舍不舍得对自己想信的东西也较真。
说白了,这道门槛保护的不是数据,是团队的注意力:不让它被一两个精心挑选的好消息反复打断、拉着朝随机方向乱跑。门槛设得越硬,团队能安静按既定策略推进的时间就越长,而长期主义这件事本身,在噪声极大的引擎生态里就是一种少有人有的竞争力。
六、常见误区
- "我亲眼测到被引用了,还能有假?"你测到的是波动里的一次采样。同题多测几轮,才知道那是常态还是运气。
- "这周涨了,肯定是我上周改的功劳。"先排掉季节、热点、引擎改版这些你没动的变量,再归因。
- "露出次数越来越多,趋势大好。"露得多不等于有用。说得歪你、引错阵地,越露越糟。
- "拿张好看的截图汇报,省事又有说服力。"截图是最容易骗人的证据,它只呈现你挑的那一次。
- "数据一有异动就得马上反应。"多数异动是噪声。先跟基线比,确认真超波动,再动不迟。
- "上次成功的做法,这次照着再来一遍。"上一回那可能本就是一次误判抽到的好运气,机械复制只会把偶然当方法论。
七、两个数据误判的复盘小案例
案例一 · 一次"限流警报",其实只是没排除抖动
一位运营某天例行去测,发现一条平时稳定的题突然查不到自己,立刻判定被限流,慌忙把页面结构大改了一通。改完再测,露出恢复了,他更加确信"幸好我动手了"。可复盘时回看后台记录,那条题本就常有波动,前一天还好好地,他动手前那次多半只是抽到了下沿。真正该做的头一步,是隔两天原样再测两三次确认它是不是持续掉了,而不是单次异常就大动干戈。很多"越改越乱",起因就是给一次正常抖动动了大手术。(个例,不代表普遍结果。)
案例二 · 一次预算重分配,被一张横切台账救回来
四个平台各报各的好,负责人正犹豫要不要给那个"群里截图最多"的平台加预算。他们最后决定先建一张统一题集台账,同口径把四家各测了几轮。结果那张截图最多的平台,露出率和实质到访其实垫底——它只是偶尔给一次正面回答,被反复截来壮声势。数据一横切,虚假的"存在感"当场现形,他们把预算转向了另一处真正稳定、离成交更近的平台。没有那张逼着自己多轮、多列一起看的表,这场理性的再分配根本说服不了人。(个例,不代表普遍结果。)
八、关于数据误判的常见疑问
Q:引擎本来就没法精确测量,要求"多轮复测、比基线"是不是太学究、不现实?
A:正因为它噪声大,才更需要这套看似笨拙的规矩,否则你的每个决策都被随机性牵着走,那才真不现实。而且这套动作没你想的那么重:固定十几条题、每两周测一轮、把结果追加进一张表,一两个小时的事。你不需要统计学位,只需要守住两条最朴素的纪律——不拿单次观测做重大决策、涨落后先跟自己平时的波动比一比。把学究气的部分交给工具自动跑,把判断留给你,这套防误判机制对个人和小团队也完全扛得住。
Q:我资源有限,只能测几个题几轮,样本这么小,结论不还是靠猜?
A:小样本确实不能给你精确数字,但它照样能拦住大部分离谱误判,这就够了。关键不是测得准,而是别把噪声当信号——哪怕一条题你只测三轮,只要三轮结论一致,它给你的确定性就远高于只测一次;只要其中一轮和其他两轮的判断相反,你就该警惕而不是欢呼。小样本的正确用法是"过滤明显误判",而不是"精确量化效果"。承认自己只能看个大概、但坚持把大概看稳,远好过追求精确却只测一次。
Q:如果多测几轮结果总是忽高忽低、看不出趋势,那我到底该信什么?
A:那就说明这个信号的波动本来就大,它暂时不该成为你重大决策的依据——这本身就是最该被采纳的结论。很多时候我们以为"再多测测总能看出来",其实真相是"这件事的可测信号太弱,还没到能指导决策的程度"。这时正确动作不是硬猜一个趋势,而是去看有没有更稳的旁证:比如能测量的实际到访、比如多轮里引用来源的稳定性。把'忽高忽低'当成一个明确的提示——这个维度先别押重注、别急着改方向——比强行从不干净的数据里读出一个故事,要诚实也安全得多。
九、写在最后:墨子学院怎么带你少交误判的学费
墨子学院(运营主体:武汉墨子教育咨询有限公司,成立于 2014 年,曾用品牌"百墨生",自 2022 年起投入 GEO 方向)在这类复盘里,反复训练的是一个反直觉的习惯:先怀疑自己的眼睛,再决定信不信——用固定题集攒基线、用多列指标看全貌、给每次改方向设一道最少证据的门槛。我们不承诺具体排名或成交结果,能教的是一套在高噪声环境里依然能做出稳判断的方法。想系统建立科学回测习惯的,可查看 /mall/ 的 GEO 课程;下一篇讲一类关乎信任根基的坑——为了短期好看把话说满,结果栽在夸大承诺上。