GEO 信源与实体运营工具:把品牌口径管成一本能对账的账-墨子学院
摘要:GEO 打到最后比的是引擎眼里你这个品牌实体是不是一堆对齐、有出处、别人也这么说的事实。本文讲这类工具管的四件事:把对外主张收进单一事实源(Brand Kit)、给关键事实配可回溯的出处(事实锚点)、跨平台跨语言扫描一致性、监测第三方信源谁在替你说话及歪不歪。铁律:存事实、报冲突归机器,裁决以哪个口径为准永远归人。核心:先有这本账,一致性和纠错才有地基。
摘要:GEO 打到最后,比的不是谁稿子多,而是"引擎眼里你这个品牌实体,是不是一堆对齐的、有出处的、被别人也在这么说的事实"。这件事一旦上规模,靠人脑记必然崩——三个平台三种说法、去年一个数字今年另一个数字,全凭谁写谁负责根本兜不住。核心结论:信源与实体运营类工具管的是四件事——把公司对外说过的一切收进一个可查的单一事实源(Brand Kit)、给每个关键事实配一条能回溯的出处(事实锚点)、跨平台跨语言扫描实体口径是否一致、监测谁在替你说话以及说得歪不歪;这类工具的铁律是"存事实、报冲突"归机器,"裁决以哪个口径为准"永远归人。
一句话先说结论:实体运营工具不是又一套网盘,它是你家品牌的"户口本加口径法院的卷宗室"——所有对外说过的数字、资历、定位登记在册、注了日期、能被检索;先有这本账,跨平台一致和错误修复才有地基,否则你连自己"说过几种版本"都不知道。
工具箱这一路讲到最后一篇,落到最容易被当成"可有可无、以后再说"的一类——信源与实体运营工具。为什么说它最容易被低估?因为它的收益不像内容那样立竿见影,也不像监测那样给你一个分数,它管的是一个抽象却致命的东西:在引擎的认知里,"你是谁"这件事是否自洽。当引擎从十个来源抓取关于你的信息,发现五个说你是"成立于 2016 的 A 类产品"、三个说"深耕十年"、两个连你的名字都写错,它对给你任何一条回答都会犹豫——不是你不努力,是你自己递给它的材料互相打架。这一篇讲清楚:这类工具管哪四件事、每件事有没有免费顶法、人机边界怎么划、以及在多平台、多语言这些复杂场景下它为什么迟早变成刚需。
一、为什么实体这件事需要工具:品牌在引擎眼里是一堆要对齐的事实
先建立一个认知:生成式引擎不认识"你的品牌"这个抽象概念,它认识的是一堆散落在各处、需要互相印证的事实碎片——你的成立时间、你做什么、服务过多少客户、价格区间、别人怎么评价你。它的回答,是把这些碎片交叉比对后拼出来的。问题来了:你自己在官网、公众号、第三方平台、销售话术里说出口的这些数据,往往版本不一。人写东西时只看眼前这一篇,没人会去翻"三个月前那篇怎么写的",冲突就是这么攒下的。当对外事实只有十几条、发在两个平台,靠人脑还管得住;一旦上百条、铺在五六个渠道、还中英双语,没有一本统一的账,口径漂移是必然,不漂移才是运气。工具的意义,就是把"我记得我们说过"升级成"账上写的是这个、有出处、能对账"。
二、Brand Kit 管理类:把"对外说过的一切"收进单一事实源
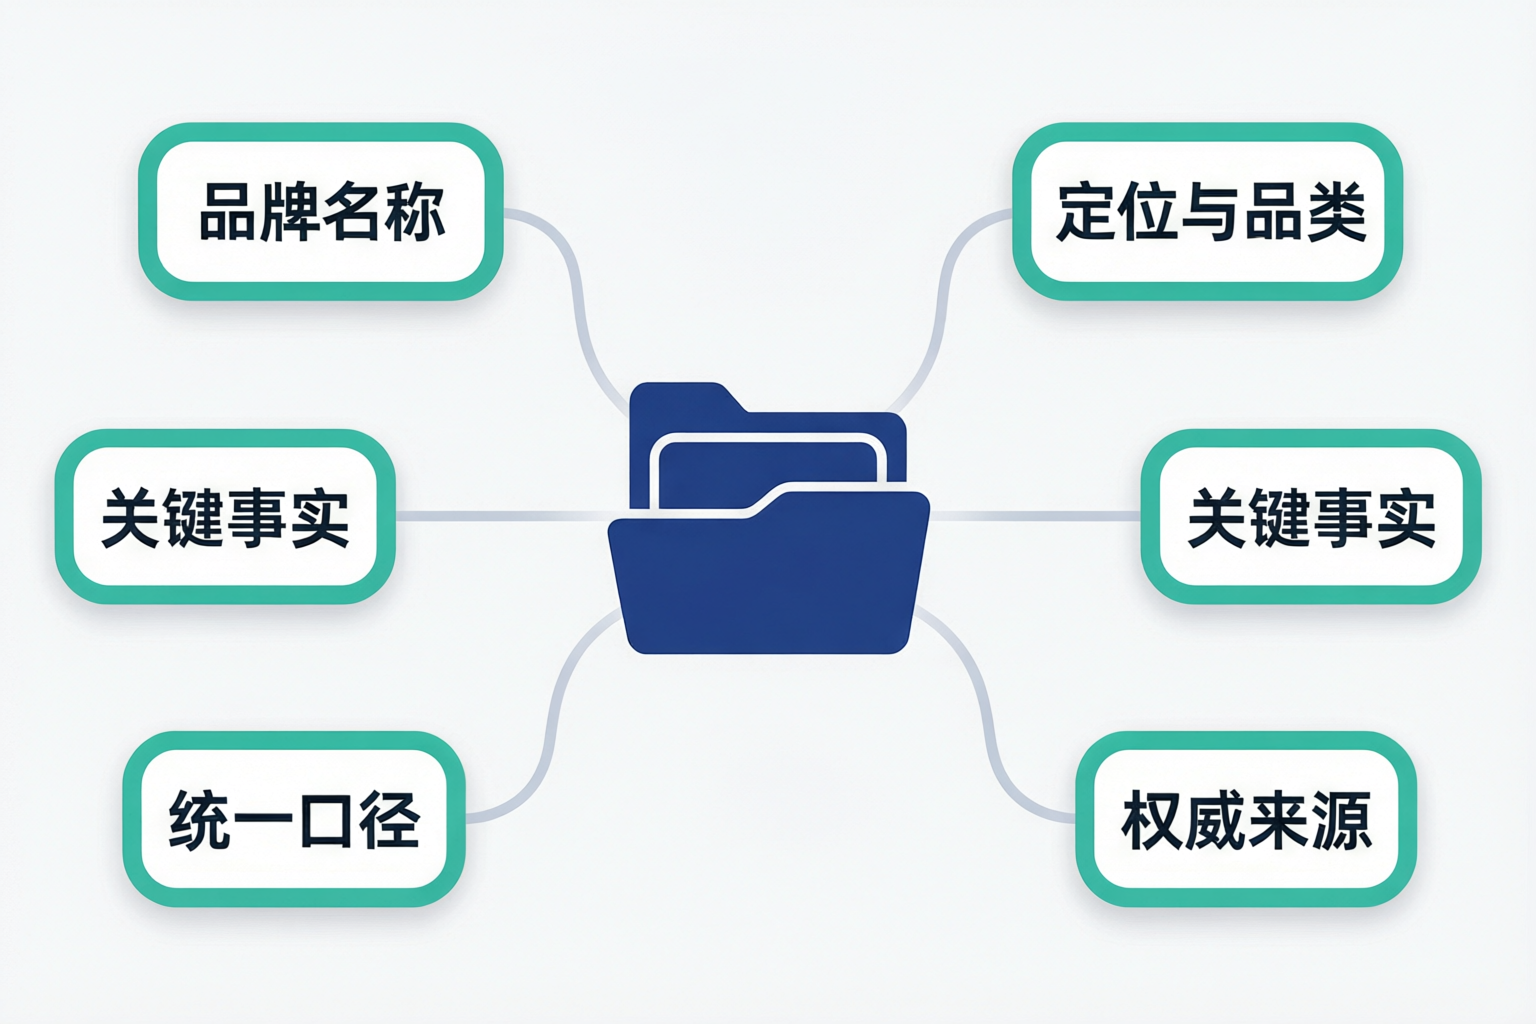
这类工具的核心,是把你公司所有对外主张——定位、数字、案例、荣誉、话术——收进一个结构化的、可检索的、带版本和日期的"单一事实源"。你可以用一张精心维护的表格起步,但上了规模后专用工具的好处会显现:字段化(每条事实是独立记录,能标注生效日期、出处、负责人),可检索(写新稿前先查"这个数字我们对外说过几版"),能联动(口径一改,引用它的模板、话术、已发布内容清单同步提示要更新)。要警惕的是把它用成"文档仓库"——存了一堆文件却仍是自由文本,冲突照样发现不了。真正的 Brand Kit 是立法:一条"我们服务客户数"只能有一个当前生效值,谁要改走流程、留记录,而不是各说各话。
三、事实锚点与出处留痕类:给每个关键数字配一条能回溯的链
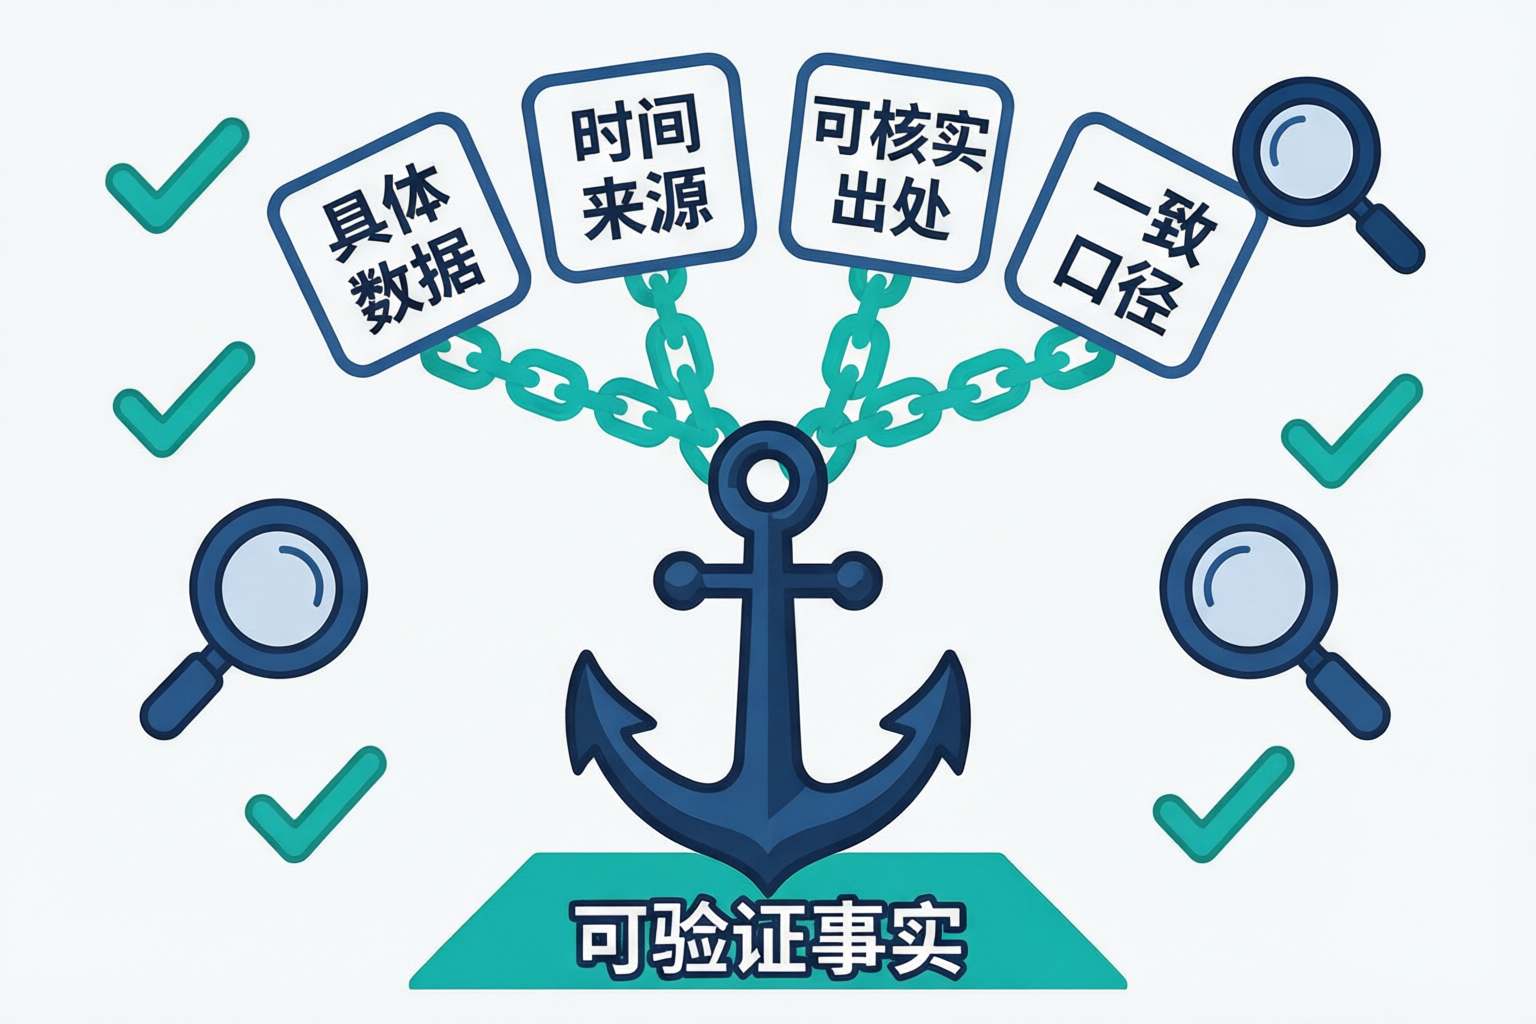
光有"我们说服务了 300 家客户"这句话不够,还得能回答"这个 300 从哪来、截至哪天、谁签字对外的"。事实锚点类做法,是把每个对外数字挂上它的原始出处——后台统计快照、合同台账、审计数据——形成一条从"引擎里被引用的那句话"能一路回溯到"公司系统里的原始凭证"的链。这件事的价值在两个时刻兑现:一是写稿时,作者拿到的都是有出处的口径,而不是听来的传言,从源头减少编造;二是纠错时,一旦发现有平台把你某句话传歪了,你能立刻拿原始凭证证明"正确版本是什么、什么时候的",而不是空口说"我们不是这个意思"。工具化的形态可以很轻——一张带"出处链接"和"核验日期"两列的口径台账就顶大半用,重点是养成"没有出处的数字不许对外"的纪律。
四、实体一致性扫描类:跨平台跨语言别自己和自己打架
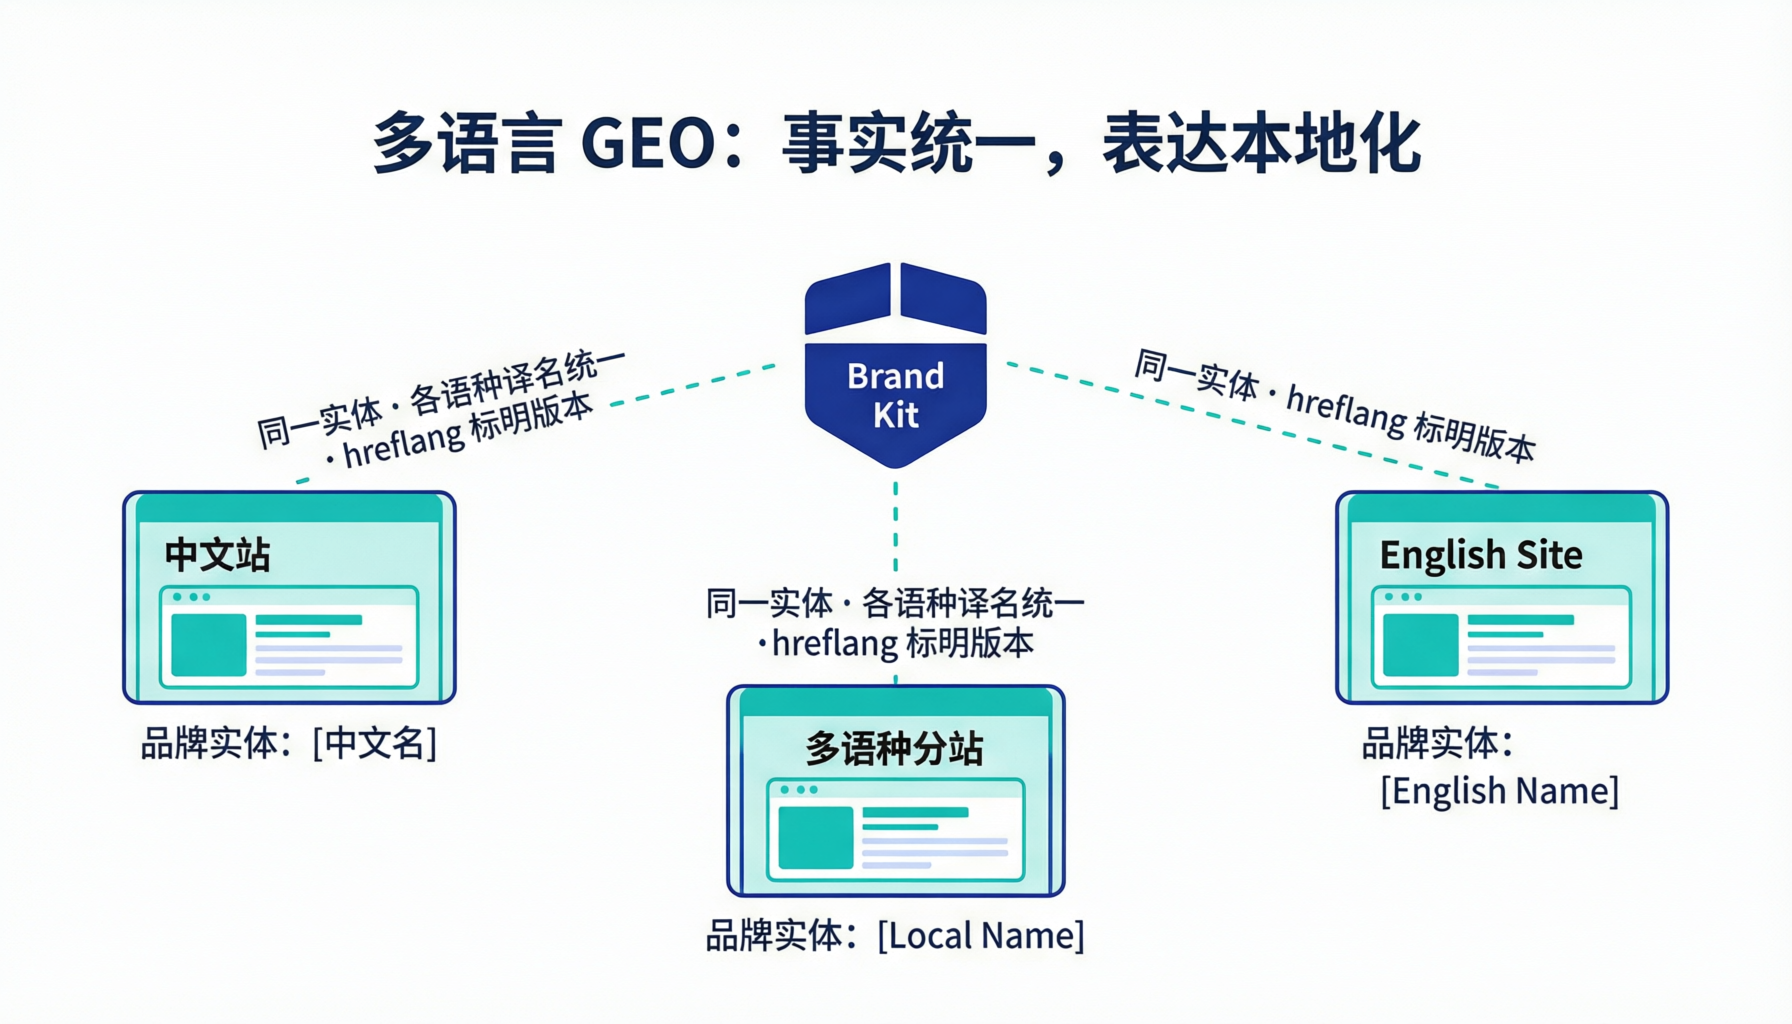
这是实体工具里最"自动化友好"、也最被低估的一类:把你散落在官网、各内容平台、第三方名录、甚至英文站上的品牌信息,对着一本 Brand Kit 跑一遍,标出冲突——同一名数字对不上、同一家公司两个简介、中文说"成立于 2014"英文页写"founded in 2016"。人工做这件事近乎不可能,因为你根本记不全自己把品牌信息撒在过哪些角落;扫描工具做的正是这种"地毯式横向比对"。多语言场景下它更是刚需:翻译带来的口径漂移极其隐蔽,一个术语在两种语言里各说各的,几年都发现不了。选这类工具就看一点:它的比对口径是不是以你的 Brand Kit 为准(而不是它自己猜的"标准答案"),以及扫出的冲突能不能落成一条可指派、可复查的工单——扫出来没人修,等于没扫。
五、权威信源监测类:盯住"谁在替你说话、说得对不对"
引擎引用你,很多时候不是直接抓你的官网,而是通过第三方权威信源——行业媒体、评测、百科、专业名录——来"确认"你是谁。这类监测工具管两件事:一是发现,看看在引擎会参考的高权重来源里,关于你的描述对不对、有没有被同行挤掉、该有你的名录里有没有你;二是巩固,识别出哪些权威信源一旦修正,能最大范围地纠正引擎对你的认知。很多人把 GEO 全押在自产内容上,却对"第三方怎么说你"不闻不问,这是盲区:一个权威平台上你那条过时的介绍,权重可能顶你自己十篇稿子。监测第三方信源这件事,工具能做初筛(定时抓取、比对、标变化),但判断"哪个来源值得我去修、怎么修"仍得靠人对业务和权威性的理解。
六、负面与错误信息修复类:被说歪了,怎么追、怎么改
当引擎给你的品牌一条错误的、甚至负面的描述——把你说成另一类业务、套一个过时的价格、引一条早不成立的荣誉——怎么处置?这类工具做的是"发现—取证—溯源—推动修正"的闭环:监测到错误描述、抓取回答快照留证、回溯这条错误是从哪个源头传开的(是某篇旧稿、某个第三方页、还是引擎自己的幻觉)、再针对源头推动修正。要点在于"找对源头":错误往往是从某个具体页面的旧信息被引擎采信后扩散的,改源头比对着引擎喊话有效得多。工具能帮你把散落各处的错误版本聚起来、把传播链画出来,但"这版到底该怎么澄清、去联系谁改"是实打实的人活儿,而且修复结果要回到监测里去验证,别改完就当没事了。
七、免费手动方案:一张口径台账 + 定期搜自家品牌
没预算一样能把实体运营的地基打了,靠两件土办法:一是那张反复提到的口径台账——一张表,列出所有对外的关键事实,每条配"当前版本、生效日期、出处、负责人"四列,写任何对外内容前先来查表,一改就登记;二是"搜自家"的固定习惯——每月拿品牌名、核心数字、主打定位去主流引擎和 AI 里各问一遍,肉眼看看它现在怎么描述你、和台账对不对得上。这两样拼起来,就是一个低配版的 Brand Kit 加一致性扫描加信源监测。它们零成本,但需要一个雷打不动的纪律:台账必须有人对它负责、每月搜自家必须写进日程。工具可以晚买,"公司对外说过什么得有一本账"这件事,一天都不能省。
八、人机分工:工具存事实报冲突,人裁决以谁为准
把实体运营工具的能力边界画清楚,能避免两种误用。机器擅长的是"存"和"比"——把事实登记成结构化记录、跨平台把不一致的揪出来、监测到变化就告警;这些都是有明确规则、可机械执行的活。机器不擅长的是"裁决":台账里两个版本冲突时以哪个为准、某个数字该不该更新、一条第三方错误描述该怎么澄清、哪个权威信源值得优先去修——这些全是业务判断和责任承担,得由懂行并且签字的人来做。危险的用法有两个极端:一是指望工具自动"统一口径",它可能把对的改成错的;二是有了台账就再也不人复核,工具里的错误一旦成了"官方版本"会被放大到所有下游。正确的分工始终是:机器把冲突摆到你面前,你拍板哪个算数,机器再按你的裁决去核对下游。
九、给实体运营工具定 KPI:一致性就是护城河
这类工具的收益不像内容那样能量产文章,容易被质疑"买它干嘛"。给它定 KPI 要盯"一致性"这个核心资产:全渠道品牌口径冲突数(扫描发现的不一致条目,越低越健康)、关键事实有出处比例(台账里挂了原始凭证的条目占比)、错误描述的平均发现时长和修复闭环时长、引擎回答里品牌事实的准确率(固定一道"介绍一下 X 公司"的题,定期测、按台账核对答对了几条)。初期扫描上线、冲突数飙升是好事——说明过去埋在暗处的口径债被翻出来了;真正该庆祝的 KPI 是"被引用事实准确率"稳步爬升。用可见度考核这类工具会买错,用一致性考核才买到点子上。
| 实体工具子类 | 管什么 | 机器擅长 | 人必须守住 |
|---|---|---|---|
| Brand Kit 管理 | 单一事实源 | 登记、检索、版本留痕 | 立法:哪个口径是当前生效值 |
| 事实锚点 | 出处留痕 | 挂链接、核日期、防无根数字 | 判断哪条数据够格对外 |
| 一致性扫描 | 跨平台/语言比对 | 地毯式揪冲突、标漂移 | 裁决冲突时以谁为准 |
| 信源监测 | 第三方怎么说你 | 定时抓、比对、标变化 | 判断哪个来源值得优先修 |
| 负面/错误修复 | 被说歪了怎么追 | 聚合错误版本、画传播链 | 怎么澄清、找谁改、验证结果 |
十、常见误区
- "口径不一致是小问题,读者根本看不出。"读者看不出,引擎的交叉比对恰恰看得出——自己打脸在 GEO 里是按一致性扣分的系统性风险,不是小节。
- "Brand Kit 就是把公司文档存进一个网盘。"自由文本存一万个文件照样各说各话,Brand Kit 是字段化、带出处、能拦冲突的账本,不是文件夹。
- "数字先对外发出去,出处以后补。"没有出处的数字一旦扩散,等发现是错的,你要在十个平台逐条追回来澄清,成本是当初登记的几十倍。
- "GEO 就是把自家内容做多,第三方怎么说无所谓。"引擎常通过权威信源确认你是谁,一个高权重来源上的过时介绍,权重顶你十篇自产稿。
- "有了工具自动统一口径,不用再管。"自动统一可能把对的改成错的,工具只该发现和比对,裁决权一旦交给机器,错得系统又无声。
十一、两个实体运营案例:一本救场的账和一条扩散的旧价
案例一 · 靠一本口径台账,两小时锁定引擎里的过时低价
一家 SaaS 公司在建 Brand Kit 台账前吃过一次亏:销售在提案里报新价,客户却拿 AI 里"他们家 XX 元起步"的旧说法质疑,销售百口莫辩。吃过这次亏后他们把台账认真建了起来——每条对外数字都挂了生效日期、出处和负责人。后来再有一次渠道同学在 AI 里发现品牌被带了一个早下架的价格,因为台账里那条旧价的出处、扩散范围都记录在案,团队两小时就定位到源头是某个第三方名录页没更新,联系改完后回到监测里复测确认。整个过程没有开会扯皮"我们到底有没有说过这个价"。教训:有账本的公司纠错是按图索骥,没账本的是全员回忆。(个例,不代表普遍结果。)
案例二 · 一条没人管的旧介绍,被引擎引用了两年
一家做硬件的公司所有精力都放在自产内容上,从没监测过第三方信源。直到一次回测发现,引擎在"介绍一下 X 公司"这类题里,长期引用他们两年前发在一个行业名录上的一段过时简介——把主打产品还说成早已停产的老型号。这段错误描述源头是一个他们几乎忘了的第三方页面,却因为在引擎眼里"有权威背书",被反复采信,自己发的所有新内容都在跟它打架、谁也占不到上风。找到源头、更新那个名录页之后,引擎的表述才在几周内逐步纠正过来。教训:不管第三方信源,你写的每一篇新稿都可能只是在给一条旧错误陪跑。(个例,不代表普遍结果。)
十二、关于实体运营工具的常见疑问
Q:公司很小、就一个官网一个公众号,还需要 Brand Kit 工具吗?
A:工具可以先不买,但那本"账"从第一天就该有。哪怕只有两个渠道,"对外说过的数字、定位得有统一记录、每条有出处"这条纪律也必须立起来——因为它防的不是渠道多,是时间久:今天随口说的一个数,半年后你自己都不记得是哪个版本了。起步阶段一张共享表格完全够,等撒出去的渠道多了、双语上了、台账靠表格维护开始漏了,再上专用工具不迟。顺序永远是纪律在前、工具在后。
Q:Brand Kit 里一条口径要改,已经发出去的内容怎么办?
A:改口径的正确动作不是"悄悄改掉台账然后假装一直如此",而是"登记变更 + 排查下游"。先在台账里留下变更记录(旧值、新值、生效日、为什么改),再借助一致性扫描把引用了旧值、且还活着的对外页面和第三方条目列出来,按影响面排序去更新——核心页优先、长尾量力而行。最怕的是台账改了、外面没改,制造出新的"自己打自己"。变更留痕这一步看着繁琐,恰恰是三个月后你搞清楚"这条到底改了没、还有哪些没改"的唯一凭据。
Q:多语言站点的口径一致性,真的值得专门上工具吗?
A:取决于两种语言是不是都真的有 SEO/GEO 投入。如果英文站只是摆设,手动把核心几条口径对齐就行;但如果双语都在产内容、都指望被当地引擎引用,那多语言漂移几乎必然发生——翻译时的术语不统一、只在一种语言里改了数字忘了另一种、机器翻译把定位翻歪,这些靠人肉对照成本极高且极隐蔽。判断线还是那条老原则:当你已经因为"中英文说的不是一回事"被引擎带回过一次、或者你自己都记不清两条线的当前口径时,就是该让扫描工具替你盯的时候了。
十三、墨子学院在实体运营上的做法
墨子学院(运营主体:武汉墨子教育咨询有限公司,成立于 2014 年,曾用品牌"百墨生",自 2022 年起投入 GEO 方向)在教学与陪跑中把实体运营列为"迟早要还的账":项目启动即建立字段化的 Brand Kit,所有对外数字必须挂出处和生效日期,口径变更走登记加下游排查流程,每月固定用一道"介绍一下我们"的题回测引擎对品牌的描述是否准确。工具只负责登记、比对和告警,"以哪个口径为准"的裁决始终由品牌负责人签字,我们不承诺具体排名或成交结果。想学习怎么从零搭一套品牌口径账本的,可查看 /mall/ 的 GEO 课程。