公众号长文怎么一键转小红书图文?知乎反爬走"另存 HTML 导入"兜底 - 墨子学院
摘要:把公众号 3000 字长文变成 8 页小红书卡片,核心难点是"抽正文"和"防反爬"。本文介绍 AI 图文卡片工具的双管策略:后端代理抽 URL + 另存 HTML 上传,附 3 分钟上手教程。
很多做小红书运营的同学手里都攒着一堆公众号长文——公司品宣、老板朋友圈、行业观察,想把它改成一串小红书卡片反复引流。难点从来不是排版,而是「怎么把正文抽出来 + 怎么绕开反爬」。AI 图文卡片工具 · 小红书风用了两条腿走路的策略:能抽就走 URL,不能抽就走本地 HTML 导入,兜底所有反爬场景。墨子学院整理了一份 3 分钟上手教程。
一、两条抽取通道
通道 A · 后端代理抓 URL
公众号(mp.weixin.qq.com)、头条、知乎专栏之外的普通博客,直接把链接粘进工具左上的 URL 输入框,后端会带自定义 UA + Referer 请求原文,再用 cheerio 解析常见正文容器:
#js_content(公众号).rich_media_content(公众号变体)article/.post-content/.article-body(通用启发式)
解析完保留段落换行 + 剔除脚本样式,把纯正文回给前端。整个过程约 500ms。
通道 B · 另存 HTML 上传
知乎、CSDN、掘金这类反爬严格的站,后端直接抓会 403 或抓到验证页。工具的兜底是:
- 浏览器打开目标文章,滚动到底让内容完全加载。
- Ctrl+S / Cmd+S,保存类型选"网页,仅 HTML"(不要选"网页,全部",节省上传体积)。
- 回到工具,点"导入本地 HTML",选中刚才存的
.html文件(≤ 8 MB)。 - 工具用同一套 cheerio 逻辑解析,效果与 URL 抓取一致。
二、抽完之后的 3 步
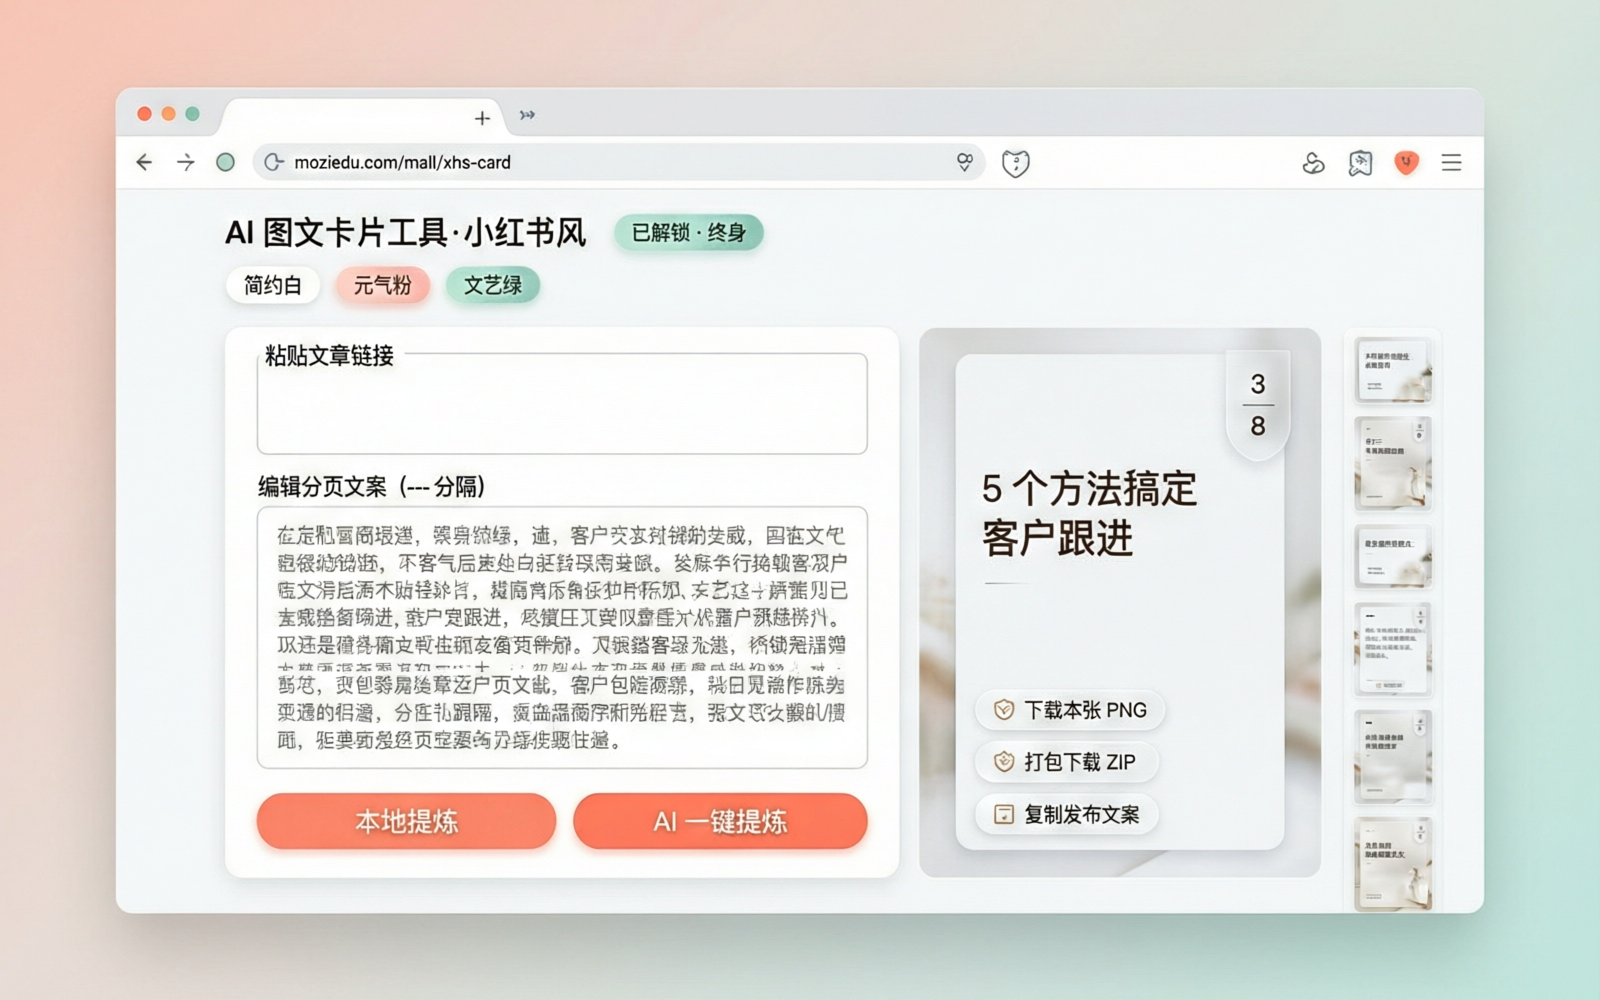
① 本地提炼或 AI 一键
正文进 textarea 后,选一种提炼方式:
- 本地提炼:纯规则,不联网、零额度。按句读切段 → 每页 100-200 字 + 首行当小标题 → 3-9 页。
- AI 一键提炼为小红书文案:走你自己的 DeepSeek / 通义千问 / Kimi / OpenAI 兼容接口 Key。生成结构 = 悬念封面标题 + 分页要点 + 互动结尾 + 话题标签。
Key 存浏览器 localStorage,请求发到本站后端一次性转发给服务商,后端不落盘、不打日志。
② 切风格
简约白 / 元气粉 / 文艺绿一键切,右侧缩略图墙 + 中间大图同步刷新。所有分页文字仍在 textarea 里可继续手改。
③ 导出
- 下载本张:当前页 PNG
- 打包 ZIP:整组(封面 + 内容 + 尾页,最多 18 张) 3:4 · 1242×1660 PNG
- 复制发布文案:标题 + 分页要点 + 话题标签一次性粘到小红书正文框
三、场景化案例
案例 1 · 公众号老板文章改小红书
把 3000 字行业观察链接粘进去 → 本地提炼 → 简约白 → 打包 ZIP。产出 7 页:封面 + 5 页要点 + 尾页,全程 40 秒。
案例 2 · 知乎高赞回答改小红书
知乎抽不到,浏览器另存 HTML → 导入 → AI 一键提炼(用你自己的 DeepSeek Key)→ 元气粉 → 下载单张封面 + 打包 ZIP。3 分钟。
案例 3 · 电商详情页文案改小红书
把小红书爆文正文反过来贴进 textarea(工具允许直接贴文字,不抽链接)→ 本地提炼 → 文艺绿 → 复制发布文案二次微调。
四、FAQ
URL 抽不到内容怎么办?
工具会返回"疑似反爬,请另存 HTML 导入"提示,不会静默失败。走通道 B 即可。
HTML 文件最大多少?
8 MB,超出会前端拦截。一般"仅 HTML"保存都在 200KB 以内,极少触发。
会上传我的公众号后台账号密码吗?
不会。工具不需要你登录任何站点,只处理你已知的公开链接或已下载的 HTML 文件。
工具入口:/mall/xhs-card · 商品页。购买即开,不限设备。